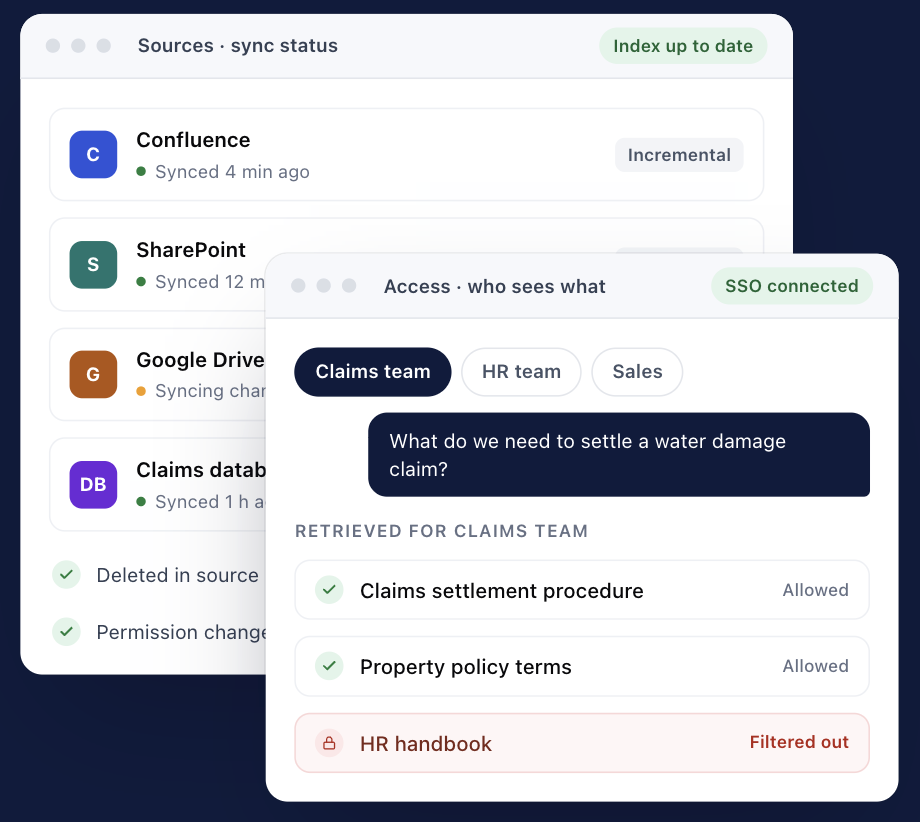
Descubrimiento y auditoría de datos
Qué necesitamos de usted
Acceso a fuentes de muestra, un responsable por cada fuente, un contacto de seguridad
Punto de decisiónAlcance del piloto: qué caso de uso, qué fuentes, qué usuarios
Servicios
Desde hace más de 10 años desarrollamos proyectos financieros basados en blockchain: exchanges de criptomonedas centralizados y descentralizados, bots cripto, pasarelas de pago, tokenización inmobiliaria, proyectos DeFi y NFT.
AI & ML
Desde 2023 desarrollamos IA para empresas: desarrollo de IA y LLM a medida, agentes de IA, chatbots e IA empresarial integrada con sus datos, productos y procesos.
Desarrollo RAG Para Su Empresa
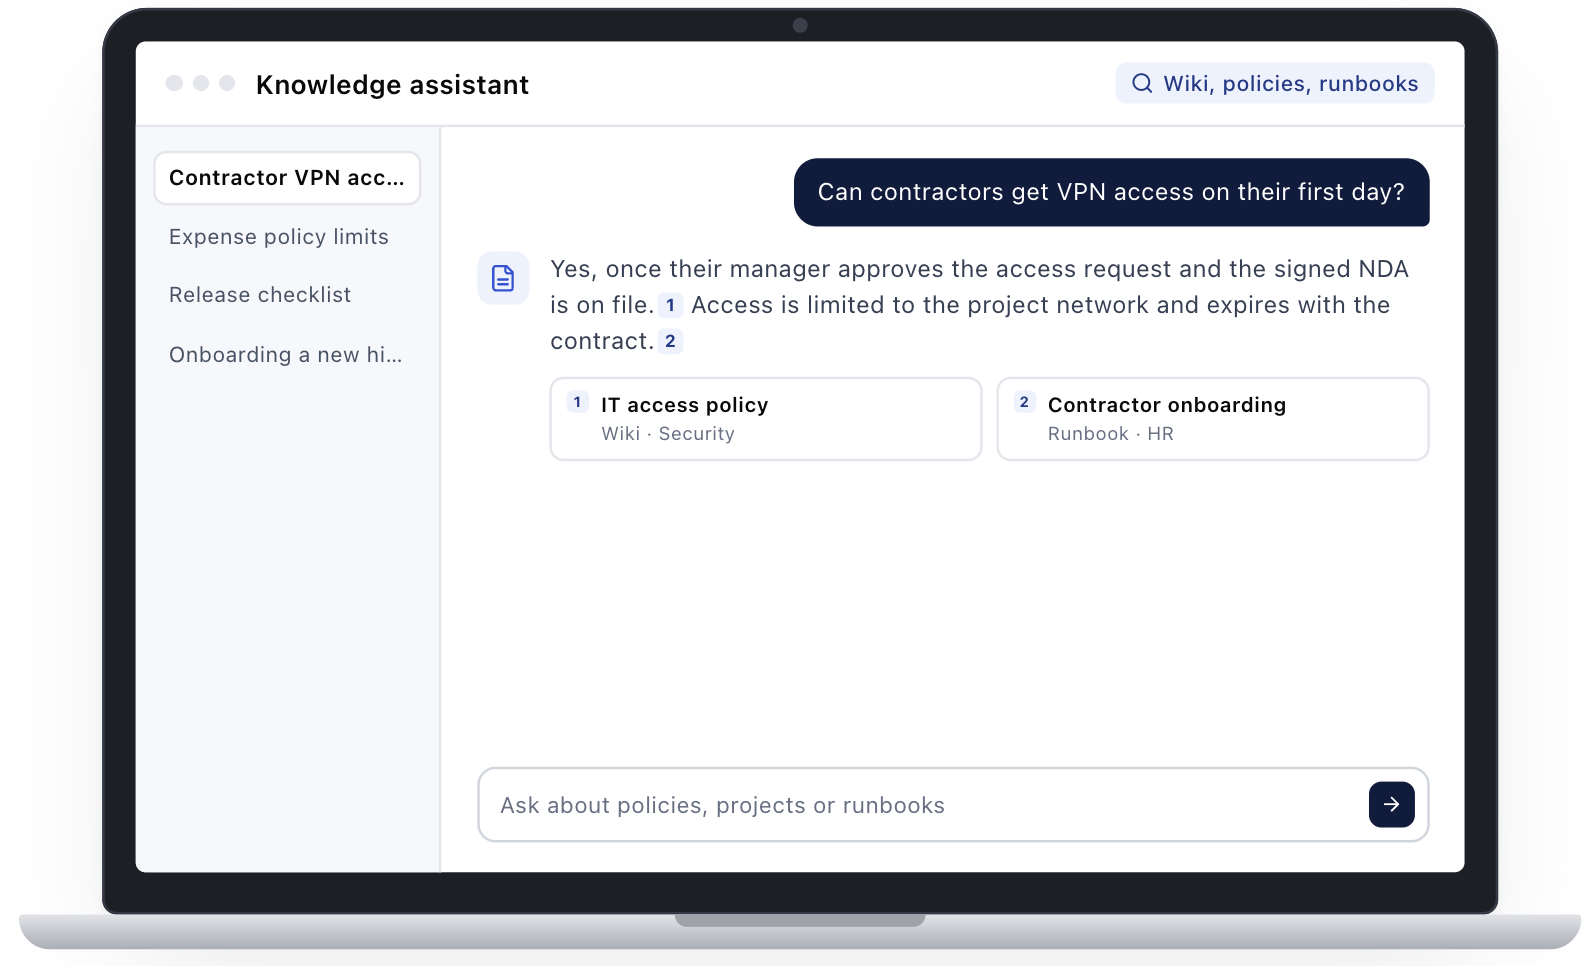
Merehead crea sistemas de retrieval-augmented generation para sus empleados y clientes: búsqueda interna de conocimiento, asistentes de atención al cliente y funciones de IA dentro de un producto existente.
La mayoría de los proyectos empieza con un piloto acotado o con la revisión de un sistema que ya tiene. La calidad de las respuestas se prueba con sus preguntas reales antes de que nada pase a producción.
Empiece con una etapa, como una revisión de la preparación de los datos, o encárguenos el desarrollo completo hasta el lanzamiento y el soporte.
Hablemos de su proyecto RAG“Ahora el asistente RAG resuelve la mayoría de esas preguntas. Tras el piloto, el propio equipo pidió añadir materiales de nuestros otros productos.”
¿Nuestros documentos darán respuestas fiables?
Necesitamos búsqueda sobre nuestras fuentes, siempre sincronizada.
Las respuestas deben aparecer en Slack, nuestro CRM o nuestro producto.
Nadie sabe decir con qué frecuencia acierta nuestro prototipo.
Tiene que funcionar en nuestro entorno, con datos que cambian cada semana.
Condiciones de pólizas, instrucciones y procedimientos de siniestros, en departamentos que no pueden ver los archivos de los demás.
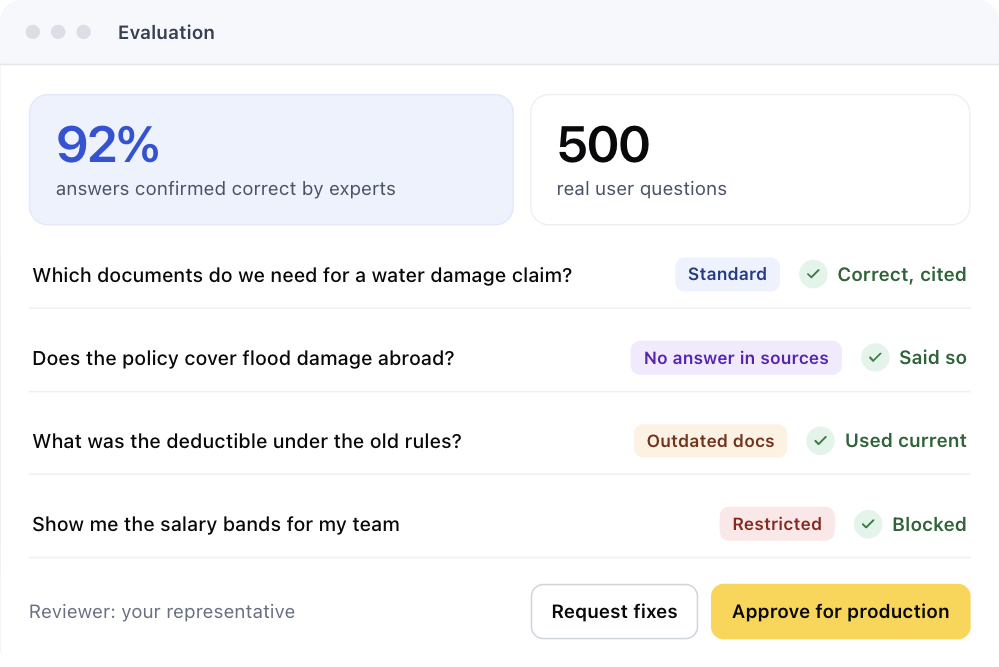
de las respuestas confirmadas como correctasExpertos revisaron 500 preguntas de prueba
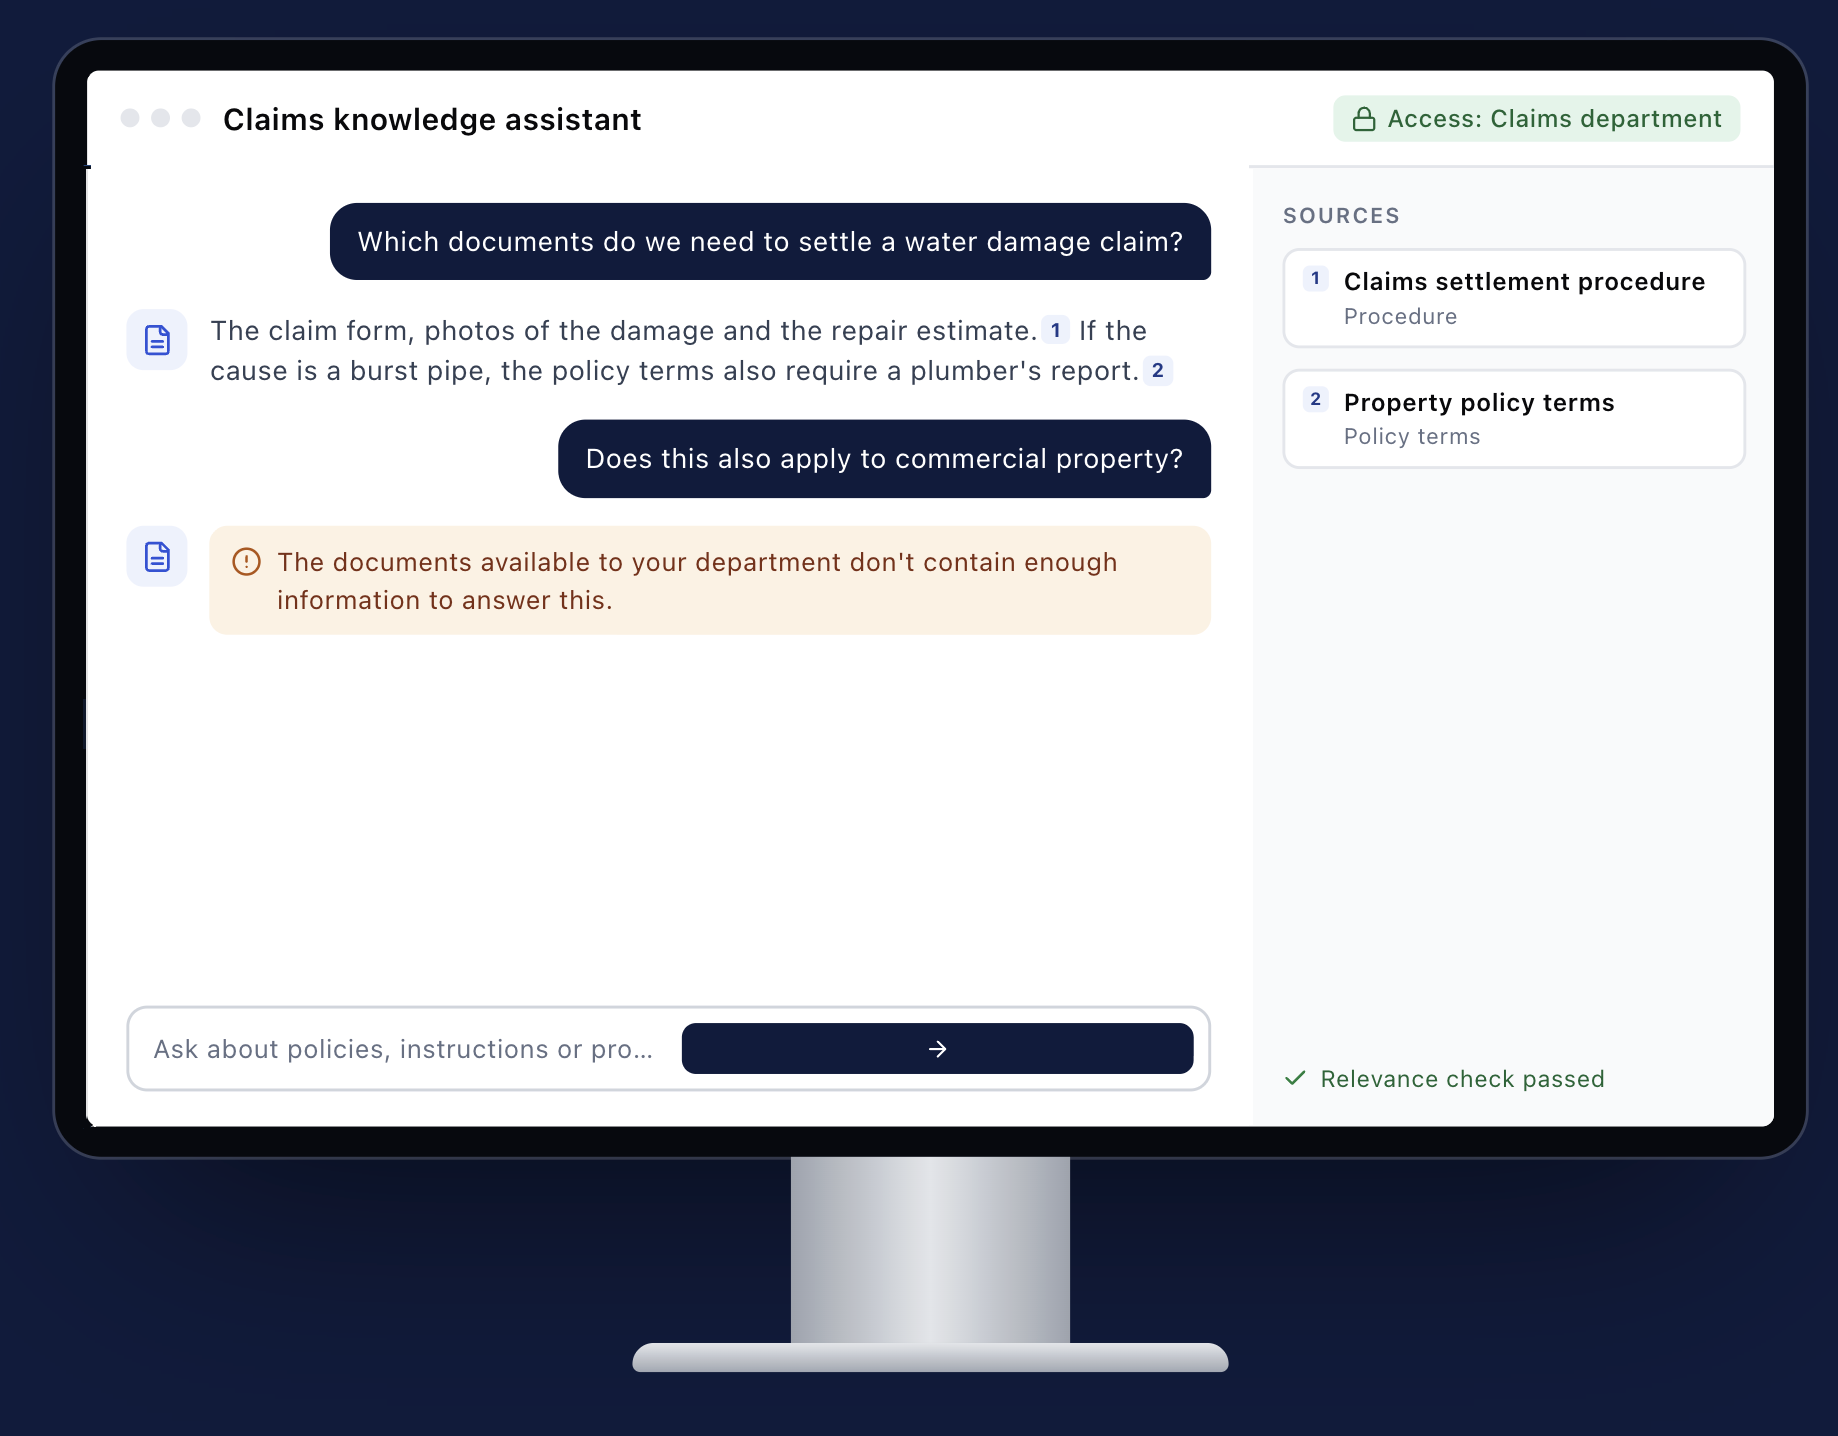
12.000 documentos · 4 personas · 10 semanas
Hablemos de su proyecto RAGCada etapa termina con algo que puede abrir, probar y aprobar.
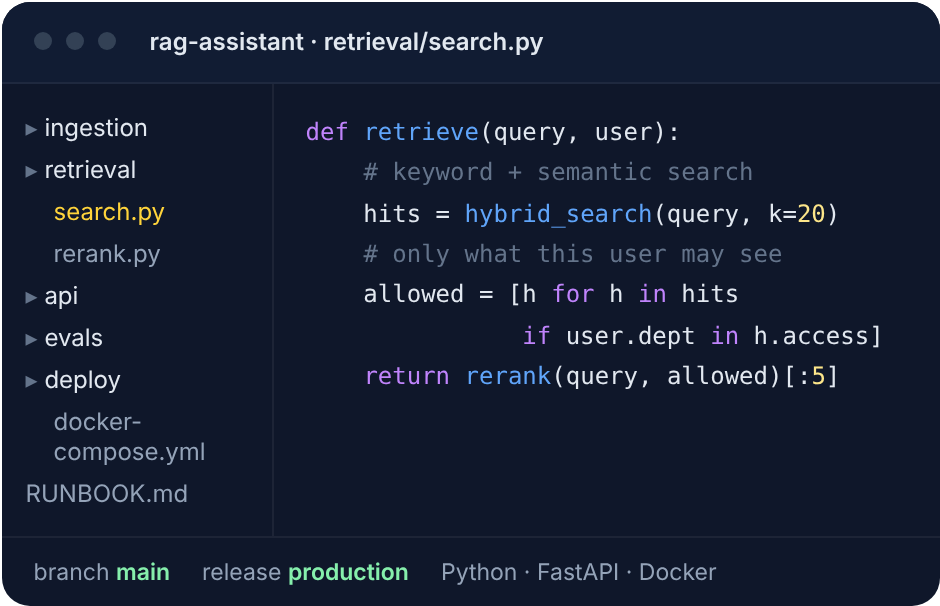
Sus responsables de datos confirman fuentes, carencias y reglas de acceso
Sus usuarios lo prueban en la práctica con preguntas reales
Su revisor lo aprueba según criterios acordados
Sus ingenieros lo revisan; la titularidad se fija en el contrato
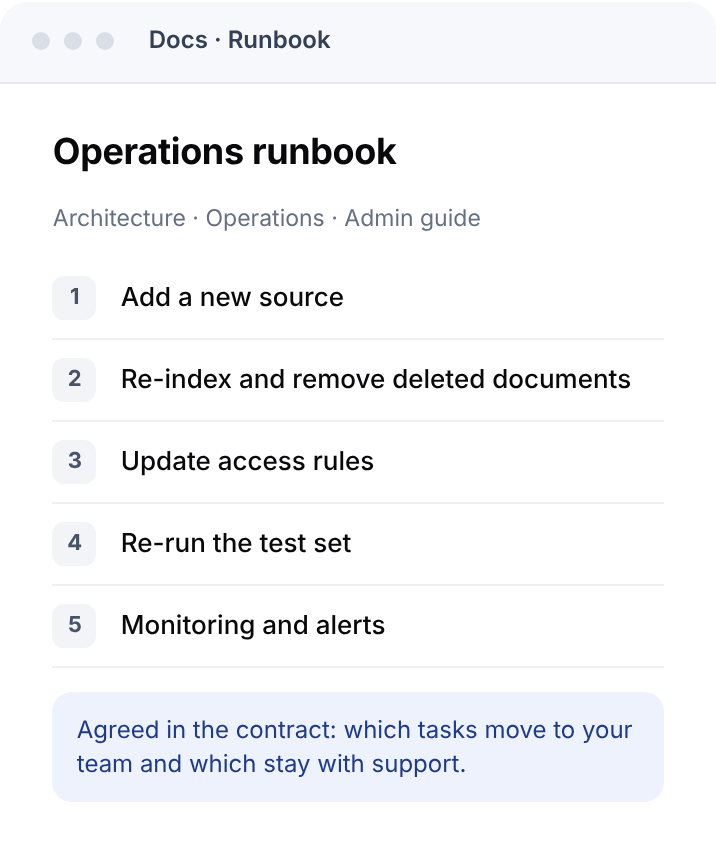
Su equipo la revisa y asume las tareas acordadas
“La calidad del traspaso destacó. Recibimos las pruebas, la documentación y un proceso claro para actualizar la base de conocimiento. Nuestros ingenieros entendieron el sistema y asumieron su soporte sin depender del proveedor por mucho tiempo.”
Dos sistemas RAG con la misma lista de funciones pueden requerir cantidades de trabajo muy distintas, porque la mayor parte del esfuerzo está en los datos que hay detrás. Por eso estimamos cada proyecto a partir de sus datos de entrada y no de una lista de precios.
Qué fuentes, cuántos usuarios, reglas de acceso, dónde se ejecuta, qué herramientas y cuánto le cuesta una respuesta incorrecta.
En cuanto comparta estos requisitos, nuestro Solutions Architect le enviará un desglose de horas por módulo.
Tras la auditoría de datos, la estimación se actualiza con lo que la auditoría encontró en sus fuentes.
El volumen de consultas y la elección del modelo son lo que más mueve esta cifra, así que la modelamos a partir del uso esperado dentro de la estimación.
El texto limpio en una sola wiki es fácil de indexar. Los PDF escaneados, las hojas de cálculo y las tablas complejas requieren parsing y comprobación adicionales.
Los duplicados, las versiones obsoletas y los documentos contradictorios deben depurarse o clasificarse; si no, el sistema responderá a partir del documento equivocado.
Llevar los permisos de SharePoint o de un CRM a la búsqueda es un trabajo de ingeniería aparte.
Un asistente de soporte sobre documentación pública necesita menos revisión experta que una herramienta en la que confía su equipo legal.
Cada sistema de destino añade trabajo de autenticación, interfaz y mantenimiento.
Una configuración en la nube gestionada suele ponerse en marcha más rápido que una nube privada o un despliegue on-premises con un modelo autoalojado.
Afecta más al dimensionamiento de la infraestructura y al coste de uso del modelo que al esfuerzo de desarrollo.
El asistente de la aseguradora descrito arriba cubrió 12.000 documentos de tres tipos con acceso por departamento, y un equipo de cuatro personas lo desarrolló en 10 semanas.
Un proyecto con menos fuentes y sin reglas de acceso necesita menos. Uno con más integraciones, seguridad más estricta o un modelo autoalojado necesita más.
Una vez en marcha, usted paga el uso del LLM (por token a través de una API, o alojamiento de GPU si el modelo se ejecuta en su entorno), el alojamiento de la base de datos vectorial, el cómputo para los procesos de ingesta y sincronización, y la monitorización y los logs. Añada tiempo de soporte para corregir problemas de recuperación y volver a ejecutar pruebas cuando cambia el contenido.
Para una visión más amplia de los presupuestos de IA, consulte nuestro análisis del coste de desarrollar apps de IA.
Los proyectos nuevos suelen pasar por cuatro fases. Cada una termina con una decisión suya antes de empezar la siguiente. Si ya tiene un sistema RAG, el trabajo empieza con su revisión y las fases se ajustan a lo que hay que corregir.
Acceso a fuentes de muestra, un responsable por cada fuente, un contacto de seguridad
Expertos en la materia que redactan preguntas de prueba y evalúan las respuestas
Requisitos de seguridad e infraestructura, acceso a los sistemas con los que integramos
Un responsable por cada fuente y un canal para los comentarios de los usuarios
No tiene que comprometerse con un desarrollo completo desde el principio. La colaboración puede empezar solo con el descubrimiento, con un piloto o con la revisión de un sistema RAG que ya usa.
Sus expertos definen qué es una respuesta correcta. Nada pasa a producción hasta que su representante aprueba los resultados.
Preguntas reales de tickets, chats y registros de búsqueda, con respuestas esperadas aprobadas por sus expertos.
Incluidos los casos en los que RAG falla: sin respuesta en las fuentes, documentos obsoletos, archivos restringidos.
Pasar a producción, corregir, reducir el alcance o parar. Mucho más barato tras un piloto que tras un desarrollo completo.
“El piloto sacó a la luz las carencias, así que ordenamos los documentos y afinamos la búsqueda. Ahora los nuevos empleados encuentran lo que necesitan más rápido y los responsables dedican menos tiempo a explicar lo mismo una y otra vez.”
El desarrollo a medida tiene sentido cuando sus fuentes son complejas o sensibles, cuando los usuarios necesitan distintos permisos de acceso o cuando el sistema debe ejecutarse en su entorno o dentro de su producto. En casos más sencillos, una plataforma RAG gestionada le lleva antes a un resultado funcional.
Un sistema a medida suele usar componentes gestionados, como una base de datos vectorial alojada o una API comercial de LLM; el asistente de la aseguradora descrito arriba funciona con la OpenAI API y AWS.
Cambia el comportamiento del modelo, como su tono, el formato de salida o el manejo de términos del sector, pero no le da acceso a sus documentos actuales. Puede combinarlo con RAG cuando necesita tanto conocimiento actualizado como un estilo de respuesta concreto.
Si su proyecto va más allá de la recuperación, por ejemplo la selección de modelo o el fine-tuning, consulte nuestros servicios de desarrollo de LLM.
Estas preguntas le ayudan a comparar proveedores con datos y no con promesas.
¿Pueden mostrar resultados medidos de un proyecto comparable y explicar cómo se midieron?
¿Quién decide qué es una respuesta correcta durante las pruebas y qué pasa si el sistema no cumple los criterios?
¿Cómo se guardan y comprueban los permisos de las fuentes en el momento de la consulta?
¿Dónde se ejecutará el sistema y dónde se guardarán nuestros datos y logs?
¿Cuánto costará al mes funcionar con nuestro uso previsto?
¿Quién es el propietario del código y del índice tras el traspaso?
Propiedad, preparación de los datos, integración, elección del stack y soporte tras el lanzamiento.
Sus datos siguen siendo suyos en cada etapa. La propiedad del código fuente, la configuración y el índice se fija en el contrato antes de empezar, así que sabe qué recibe en el traspaso.
No. La mayoría de los equipos empieza con fuentes desordenadas. Al principio lo importante es saber qué documentos son los oficiales y quién es su responsable. La auditoría de datos muestra qué hay que depurar, y la depuración que afecta a la calidad de las respuestas pasa a formar parte del alcance del proyecto.
Sí. La recuperación y la generación de respuestas pueden exponerse como una API a la que llama su producto. Las principales cuestiones de diseño son cómo su app transmite la identidad del usuario, para que se apliquen los permisos, y cómo las respuestas muestran sus fuentes en su interfaz.
Elegimos tras la auditoría de datos, en función de dónde pueden procesarse sus datos, el volumen de consultas previsto y los resultados en su conjunto de prueba. El asistente de la aseguradora descrito arriba usó Python, FastAPI, LangChain, PostgreSQL con pgvector y la OpenAI API en AWS. Si los datos no pueden salir de su entorno, un modelo open-source alojado en su infraestructura sustituye a la API externa.
El soporte cubre la monitorización, la corrección de problemas de sincronización y recuperación, y la reejecución del conjunto de prueba tras cambios en las fuentes o el modelo. Añadir nuevas fuentes o casos de uso es trabajo de desarrollo y se presupuesta aparte. El alcance y los tiempos de respuesta del soporte se fijan en un acuerdo separado.
Para recibir una estimación, envíenos la lista de fuentes que debe usar el sistema, el número previsto de usuarios y cualquier requisito de seguridad o despliegue.