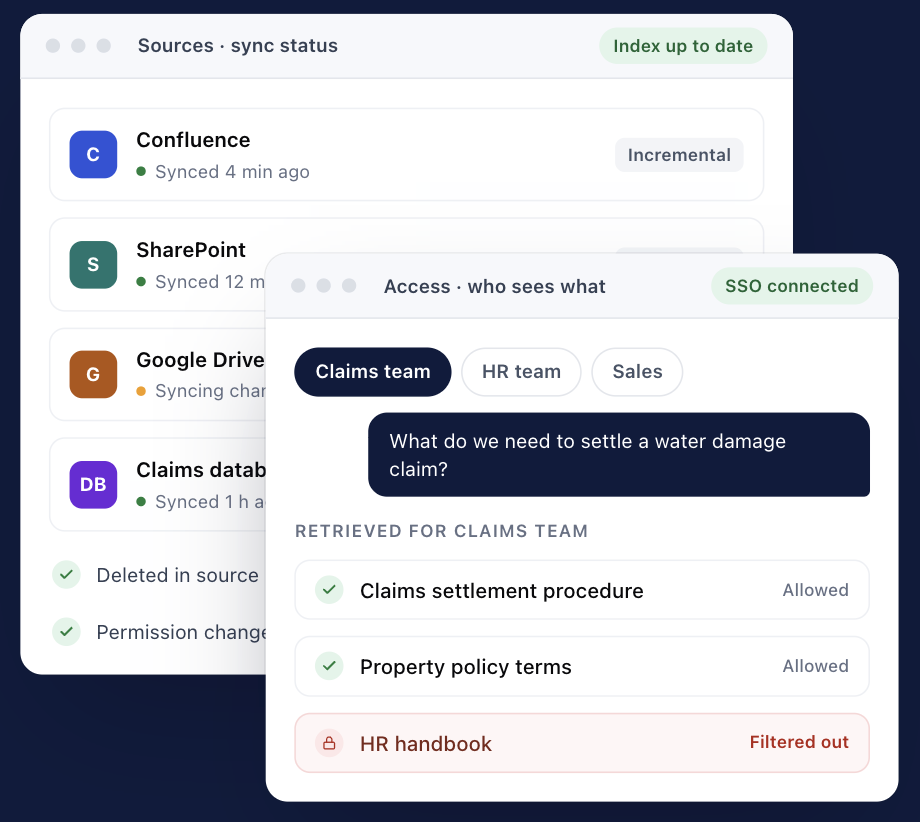
Descoberta e auditoria de dados
O que precisamos de você
Acesso a fontes de amostra, um responsável por cada fonte, um contato de segurança
Ponto de decisãoEscopo do piloto: qual caso de uso, quais fontes, quais usuários
Serviços
Há mais de 10 anos criamos projetos financeiros baseados em blockchain: exchanges de criptomoedas centralizadas e descentralizadas, bots cripto, gateways de pagamento, tokenização imobiliária, projetos DeFi e NFT.
AI & ML
Desde 2023 desenvolvemos IA para empresas: desenvolvimento de IA e LLM sob medida, agentes de IA, chatbots e IA corporativa integrada aos seus dados, produtos e processos.
Desenvolvimento RAG Para A Sua Empresa
A Merehead cria sistemas de retrieval-augmented generation para seus funcionários e clientes: busca interna de conhecimento, assistentes de suporte ao cliente e recursos de IA dentro de um produto existente.
A maioria dos projetos começa com um piloto de escopo definido ou com a revisão de um sistema que você já tem. A qualidade das respostas é testada com suas perguntas reais antes de qualquer coisa ir para produção.
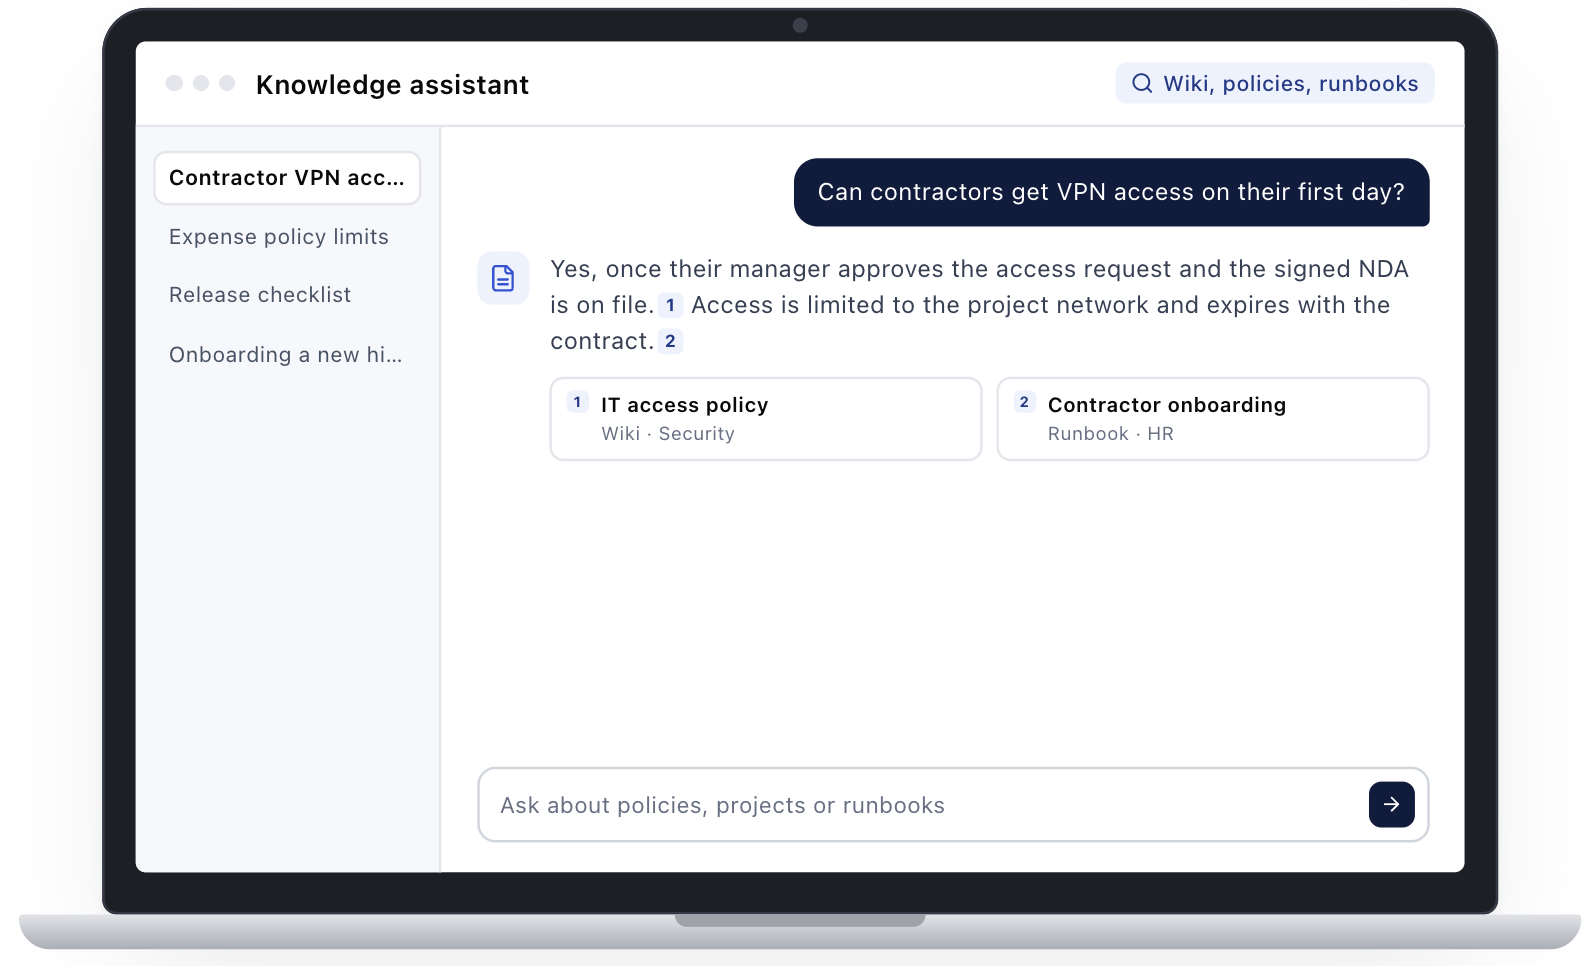
Comece com uma etapa, como uma verificação de prontidão dos dados, ou deixe conosco o desenvolvimento completo até o lançamento e o suporte.
Discutir seu projeto de RAG“Agora o assistente RAG resolve a maioria dessas perguntas. Depois do piloto, a própria equipe pediu para adicionar materiais dos nossos outros produtos.”
Nossos documentos vão gerar respostas confiáveis?
Precisamos de busca sobre nossas fontes, sempre sincronizada.
As respostas precisam aparecer no Slack, no nosso CRM ou no nosso produto.
Ninguém sabe dizer com que frequência nosso protótipo acerta.
Tem que rodar no nosso ambiente, com dados que mudam toda semana.
Termos de apólices, instruções e procedimentos de sinistros, em departamentos que não podem ver os arquivos uns dos outros.
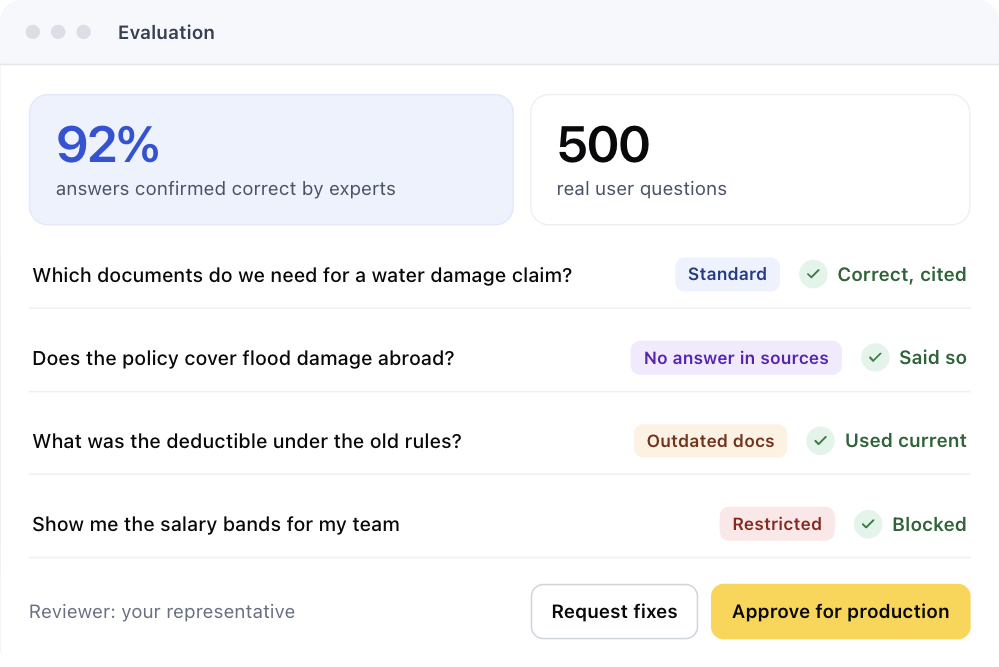
das respostas confirmadas como corretasEspecialistas revisaram 500 perguntas de teste
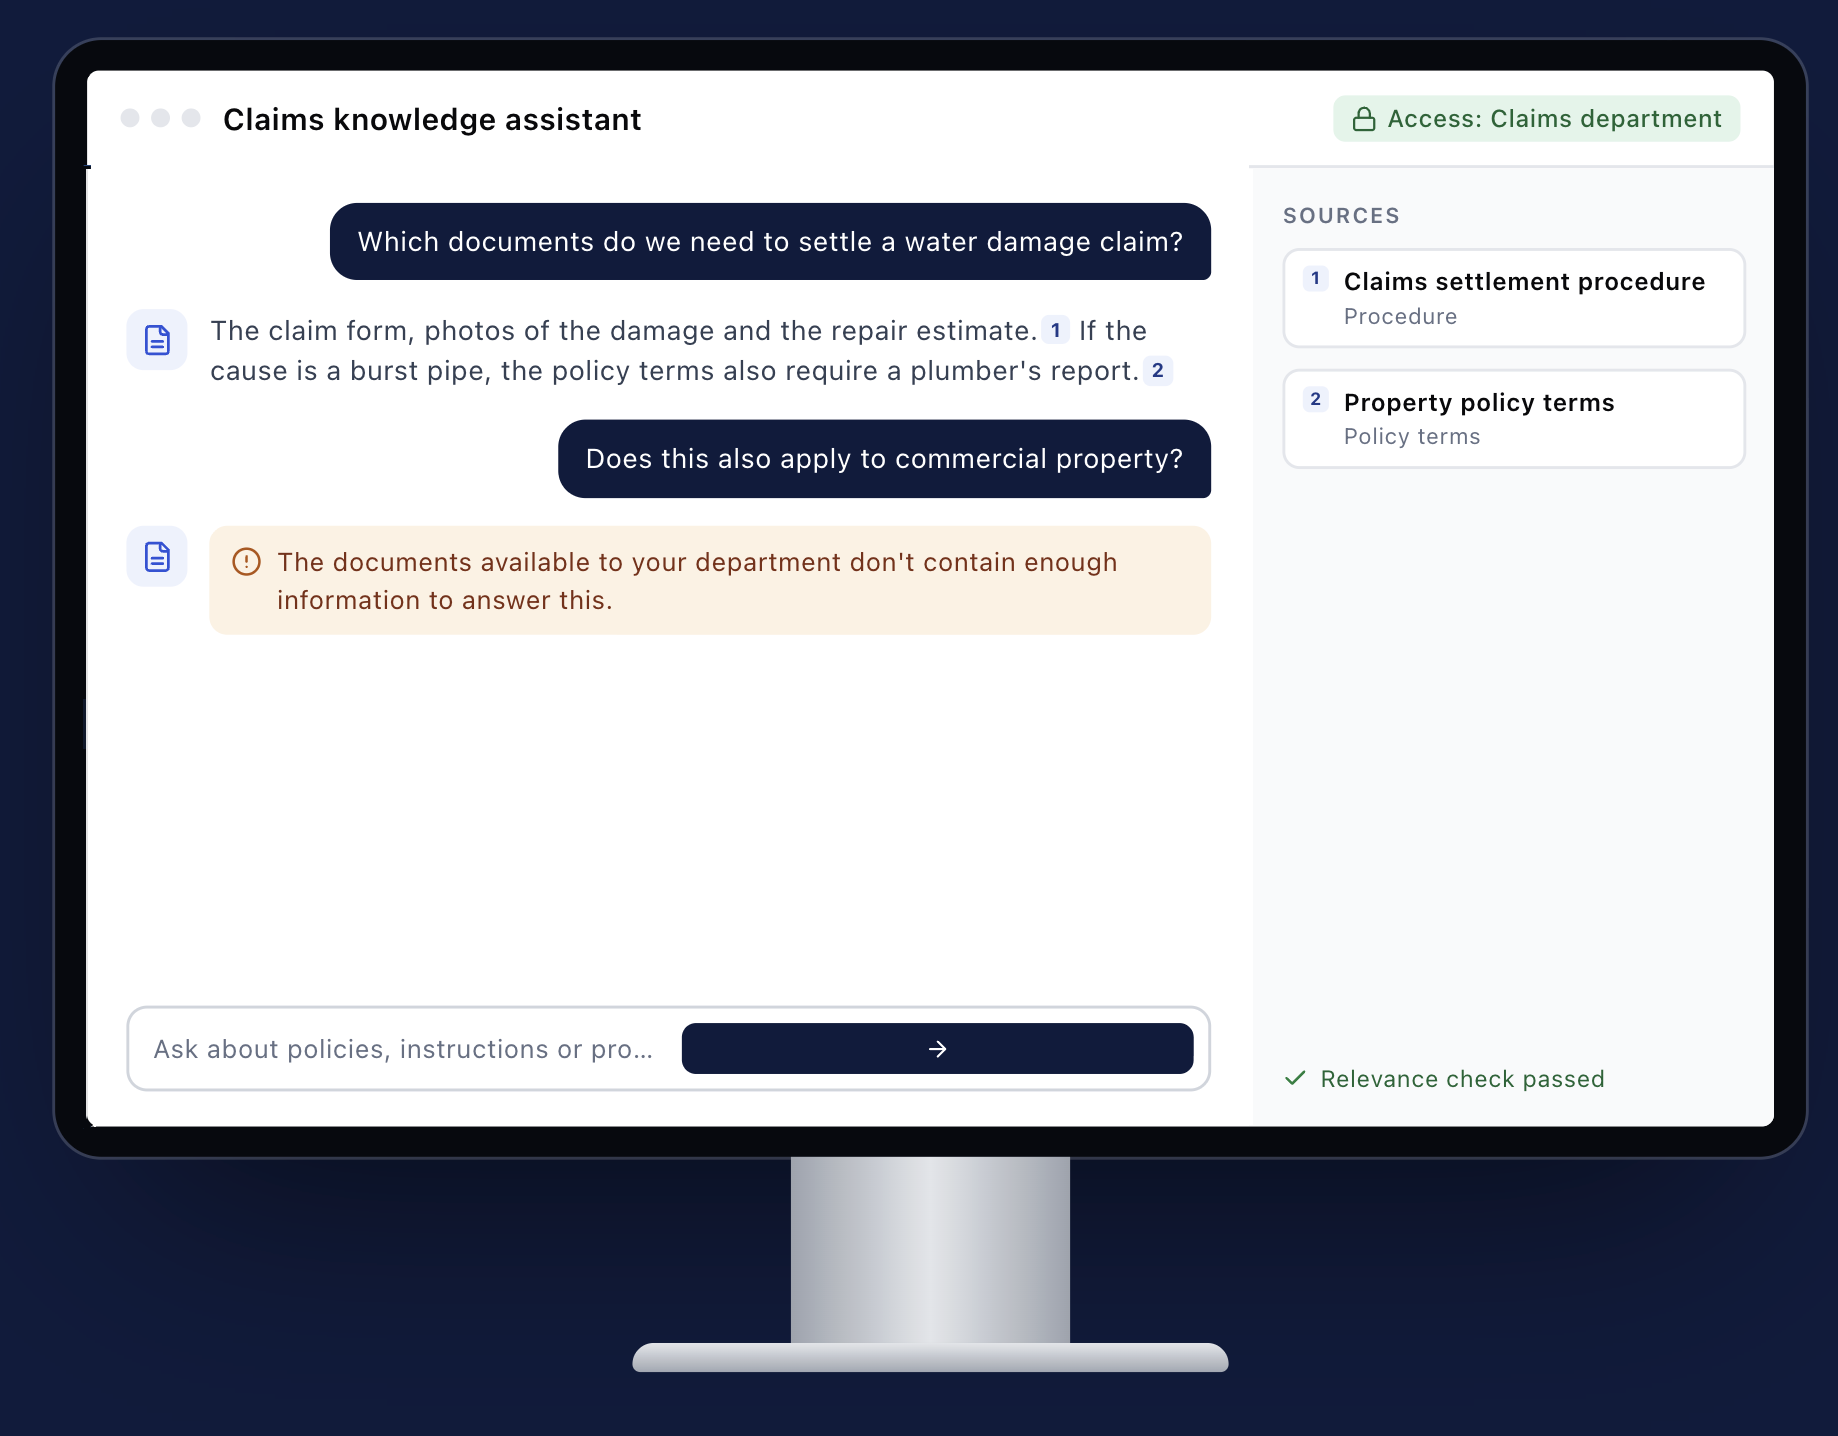
12.000 documentos · 4 pessoas · 10 semanas
Discutir seu projeto de RAGCada etapa termina com algo que você pode abrir, testar e aprovar.
Seus responsáveis pelos dados confirmam fontes, lacunas e regras de acesso
Seus usuários o testam na prática com perguntas reais
Seu revisor o aprova com base em critérios acordados
Seus engenheiros o revisam; a titularidade é definida em contrato
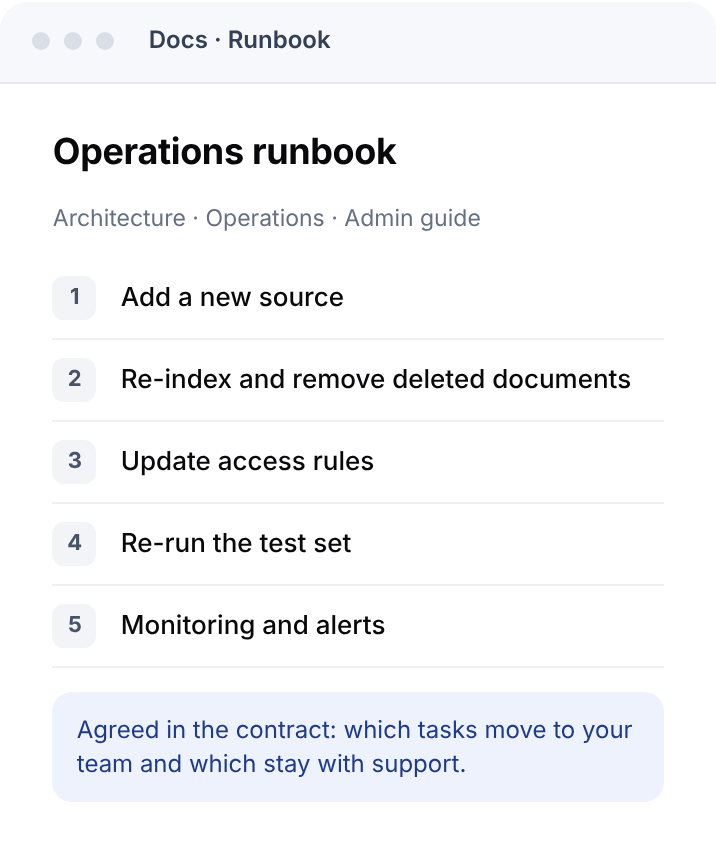
Sua equipe a revisa e assume as tarefas acordadas
“A qualidade do handover chamou a atenção. Recebemos os testes, a documentação e um processo claro para atualizar a base de conhecimento. Nossos engenheiros entenderam o sistema e assumiram o suporte sem depender do fornecedor por muito tempo.”
Dois sistemas RAG com a mesma lista de recursos podem exigir volumes de trabalho muito diferentes, porque a maior parte do esforço está nos dados por trás deles. Por isso estimamos cada projeto a partir dos seus insumos, e não de uma tabela de preços.
Quais fontes, quantos usuários, regras de acesso, onde vai rodar, quais ferramentas e quanto custa uma resposta errada para você.
Assim que você compartilha esses requisitos, nosso Solutions Architect envia uma estimativa de horas por módulo.
Após a auditoria de dados, a estimativa é atualizada com o que a auditoria encontrou nas suas fontes.
Texto limpo em uma única wiki é simples de indexar. PDFs digitalizados, planilhas e tabelas complexas exigem parsing e verificação adicionais.
Duplicatas, versões desatualizadas e documentos contraditórios precisam ser limpos ou classificados, senão o sistema responderá a partir do documento errado.
Levar as permissões do SharePoint ou de um CRM para a busca é um trabalho de engenharia à parte.
Um assistente de suporte para documentação pública precisa de menos revisão especializada do que uma ferramenta em que sua equipe jurídica confia.
Cada sistema de destino acrescenta trabalho de autenticação, interface e manutenção.
Uma configuração em nuvem gerenciada costuma ficar pronta mais rápido do que uma nuvem privada ou implantação on-premises com modelo auto-hospedado.
Afeta mais o dimensionamento da infraestrutura e os custos de uso do modelo do que o esforço de desenvolvimento.
O assistente da seguradora cobriu 12.000 documentos com acesso por departamento e levou 10 semanas com uma equipe de quatro pessoas.
Volume de consultas e escolha do modelo são o que mais influencia esse valor, por isso o modelamos a partir do uso esperado como parte da estimativa.
Com o sistema no ar, você paga pelo uso do LLM (por token via API, ou hospedagem de GPU se o modelo roda no seu ambiente), hospedagem do banco de dados vetorial, processamento para ingestão e sincronização, e monitoramento e logs. Some o tempo de suporte para corrigir problemas de busca e reexecutar testes quando o conteúdo muda.
Para uma visão mais ampla de orçamentos de IA, veja nossa análise do custo de desenvolvimento de apps de IA.
Projetos novos costumam passar por quatro fases. Cada uma termina com uma decisão sua antes de a próxima começar. Se você já tem um sistema RAG, o trabalho começa com a revisão dele, e as fases são ajustadas ao que precisa ser corrigido.
Acesso a fontes de amostra, um responsável por cada fonte, um contato de segurança
Especialistas no assunto que escrevem perguntas de teste e avaliam as respostas
Requisitos de segurança e infraestrutura, acesso aos sistemas que vamos integrar
Um responsável por cada fonte e um canal para o feedback dos usuários
Seus especialistas definem o que é uma resposta correta. Nada vai para produção até que seu representante aprove os resultados.
Perguntas reais de tickets, chats e logs de busca, com respostas esperadas aprovadas pelos seus especialistas.
Incluindo os casos em que o RAG falha: sem resposta nas fontes, documentos desatualizados, arquivos restritos.
Ir para produção, corrigir, reduzir o escopo ou parar. Muito mais barato após um piloto do que após o desenvolvimento completo.
“O piloto expôs as lacunas, então organizamos os documentos e refinamos a busca. Agora os novos funcionários encontram o que precisam mais rápido e os gestores gastam menos tempo explicando as mesmas coisas.”
O desenvolvimento personalizado faz sentido quando suas fontes são complexas ou sensíveis, quando os usuários precisam de direitos de acesso diferentes, ou quando o sistema precisa rodar no seu ambiente ou dentro do seu produto. Em casos mais simples, uma plataforma RAG gerenciada leva a um resultado funcional mais rápido.
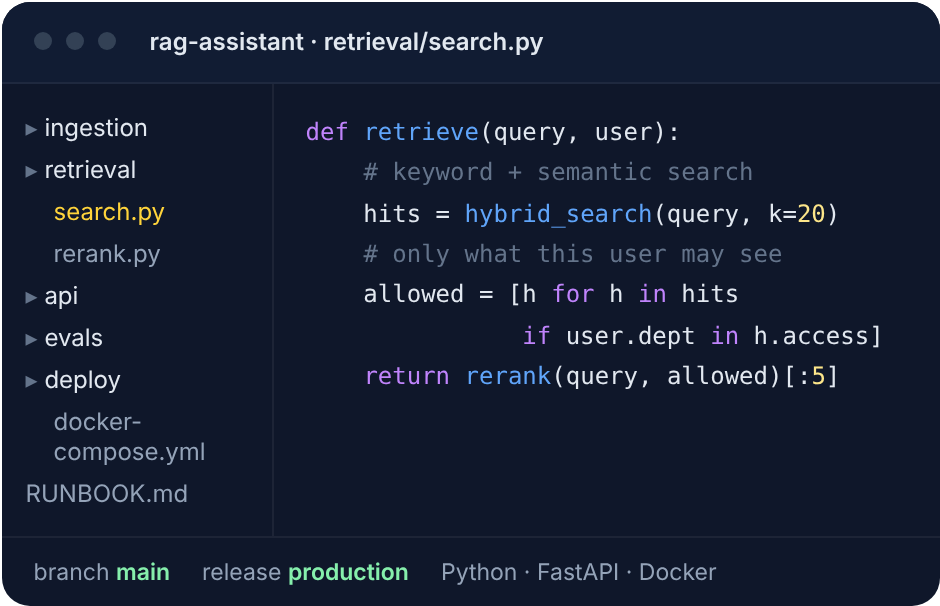
Um sistema personalizado costuma usar componentes gerenciados, como um banco de dados vetorial hospedado ou uma API comercial de LLM; o assistente da seguradora acima roda na OpenAI API e na AWS.
Ele muda o comportamento do modelo, como tom, formato de saída ou tratamento de termos do domínio, mas não dá ao modelo acesso aos seus documentos atuais. Você pode combiná-lo com RAG quando precisa tanto de conhecimento atualizado quanto de um estilo de resposta específico.
Se o seu projeto vai além da busca, por exemplo seleção de modelo ou fine-tuning, veja nossos serviços de desenvolvimento de LLM.
Propriedade, prontidão dos dados, integração, escolha da stack e suporte após o lançamento.
Seus dados continuam sendo seus, e a titularidade do código, da configuração e do índice é definida em contrato antes do início do trabalho.
Não. A maioria das equipes começa com fontes desorganizadas. O que importa no início é saber quais documentos são oficiais e quem é responsável por eles. A auditoria de dados mostra o que precisa ser limpo, e a limpeza que afeta a qualidade das respostas passa a fazer parte do escopo do projeto.
Sim. A busca e a geração de respostas podem ser expostas como uma API chamada pelo seu produto. As principais questões de design são como seu app repassa a identidade do usuário, para que as permissões se apliquem, e como as respostas mostram suas fontes na sua interface.
Escolhemos após a auditoria de dados, com base em onde seus dados podem ser processados, no volume de consultas esperado e nos resultados no seu conjunto de teste. O assistente da seguradora descrito acima usou Python, FastAPI, LangChain, PostgreSQL com pgvector e a OpenAI API na AWS. Se os dados não podem sair do seu ambiente, um modelo open-source hospedado na sua infraestrutura substitui a API externa.
O suporte cobre monitoramento, correção de problemas de sincronização e busca, e reexecução do conjunto de teste após mudanças de fontes ou de modelo. Adicionar novas fontes ou casos de uso é trabalho de desenvolvimento e tem escopo à parte. O escopo e os prazos de resposta do suporte são definidos em um acordo separado.
Para receber uma estimativa, envie a lista de fontes que o sistema deve usar, o número esperado de usuários e eventuais requisitos de segurança ou implantação.