Discovery e audit dei dati
Cosa ci serve da voi
Accesso a fonti di esempio, un responsabile per ogni fonte, un referente per la sicurezza
Punto di decisionePerimetro del pilota: quale caso d'uso, quali fonti, quali utenti
Servizi
Da oltre 10 anni realizziamo progetti finanziari basati su blockchain: exchange di criptovalute centralizzati e decentralizzati, bot crypto, gateway di pagamento, tokenizzazione immobiliare, progetti DeFi e NFT.
AI & ML
Dal 2023 sviluppiamo AI per le aziende: sviluppo di AI e LLM su misura, agenti AI, chatbot e AI enterprise integrata con i vostri dati, prodotti e processi.
Sviluppo RAG Per La Vostra Azienda
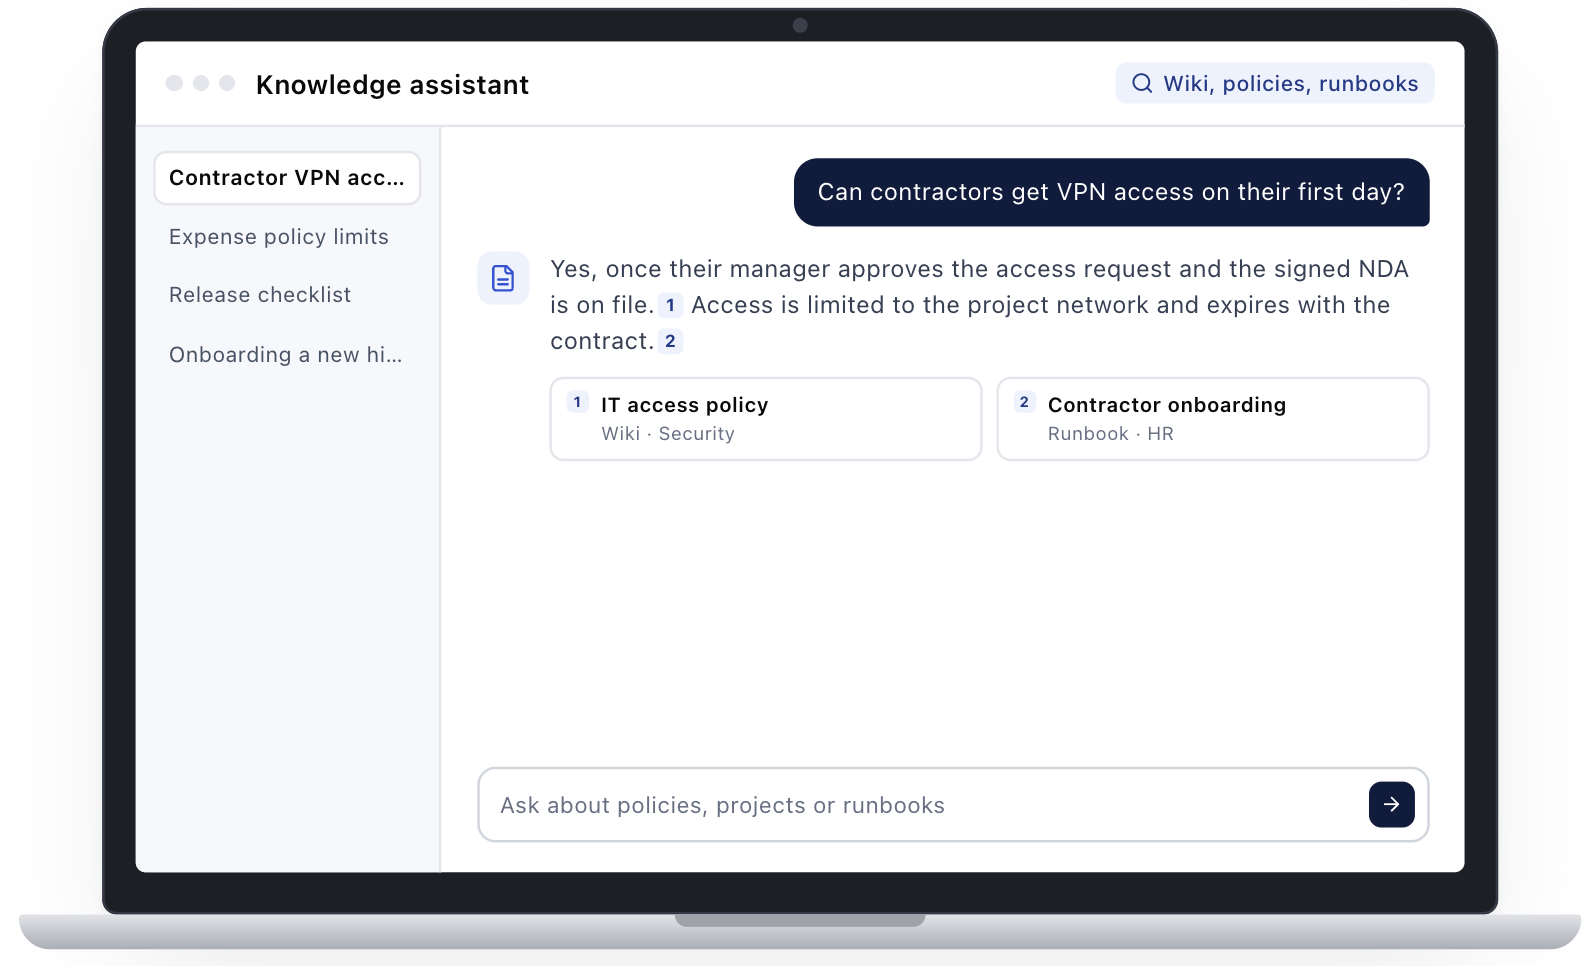
Merehead realizza sistemi di retrieval-augmented generation per i vostri dipendenti e clienti: ricerca interna nella knowledge base, assistenti per il supporto clienti e funzionalità AI all'interno di un prodotto esistente.
La maggior parte dei progetti parte da un pilota circoscritto o dalla revisione di un sistema che avete già. La qualità delle risposte viene testata sulle vostre domande reali prima che qualsiasi cosa vada in produzione.
Iniziate da una sola fase, come una verifica della prontezza dei dati, oppure affidateci lo sviluppo completo fino al lancio e al supporto.
Parliamo del vostro progetto RAG“Ora l’assistente RAG gestisce la maggior parte di queste domande. Dopo il pilota, è stato il team stesso a chiedere di aggiungere i materiali degli altri nostri prodotti.”
I nostri documenti daranno risposte affidabili?
Ci serve una ricerca sulle nostre fonti, sempre sincronizzata.
Le risposte devono comparire in Slack, nel nostro CRM o nel nostro prodotto.
Nessuno sa dire quanto spesso il nostro prototipo risponde correttamente.
Deve funzionare nel nostro ambiente, su dati che cambiano ogni settimana.
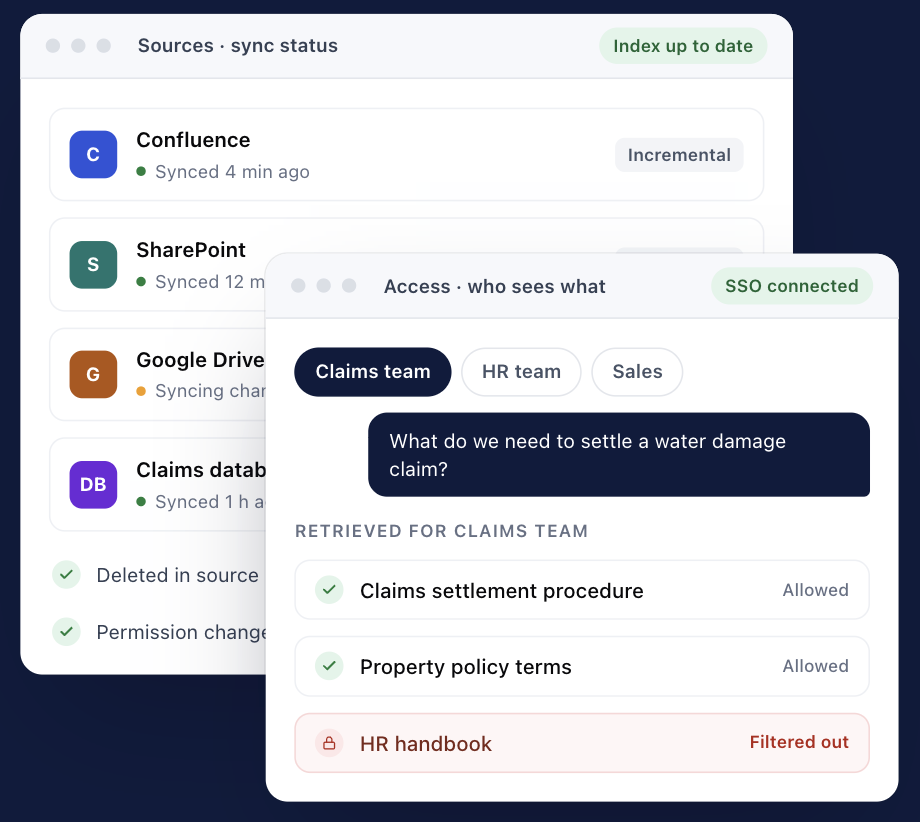
Condizioni di polizza, istruzioni e procedure di liquidazione dei sinistri, in reparti che non possono vedere i file degli altri.
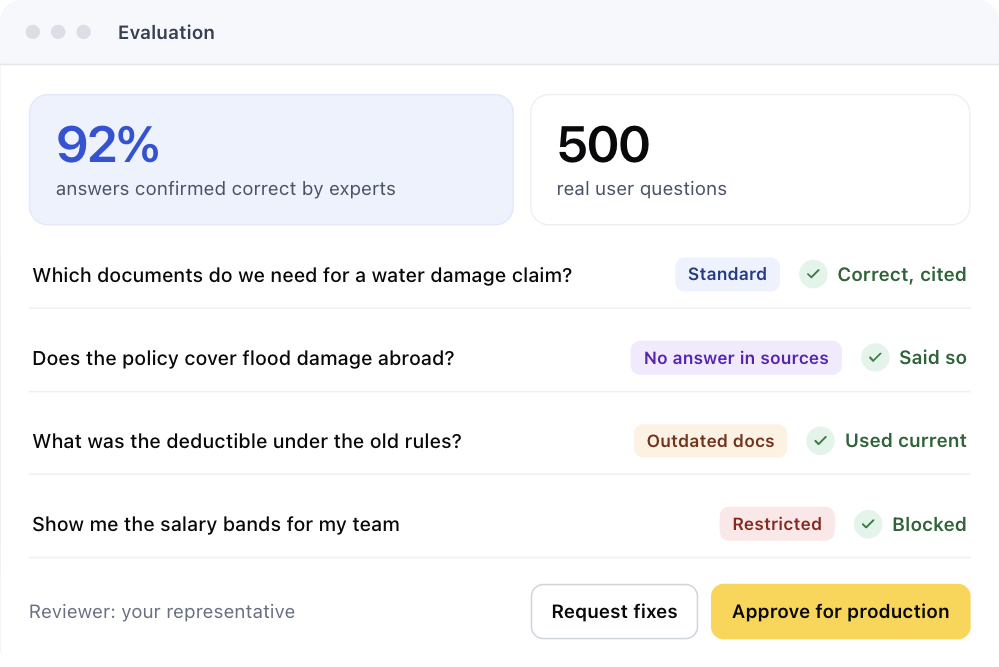
delle risposte confermate come corretteGli esperti hanno revisionato 500 domande di test
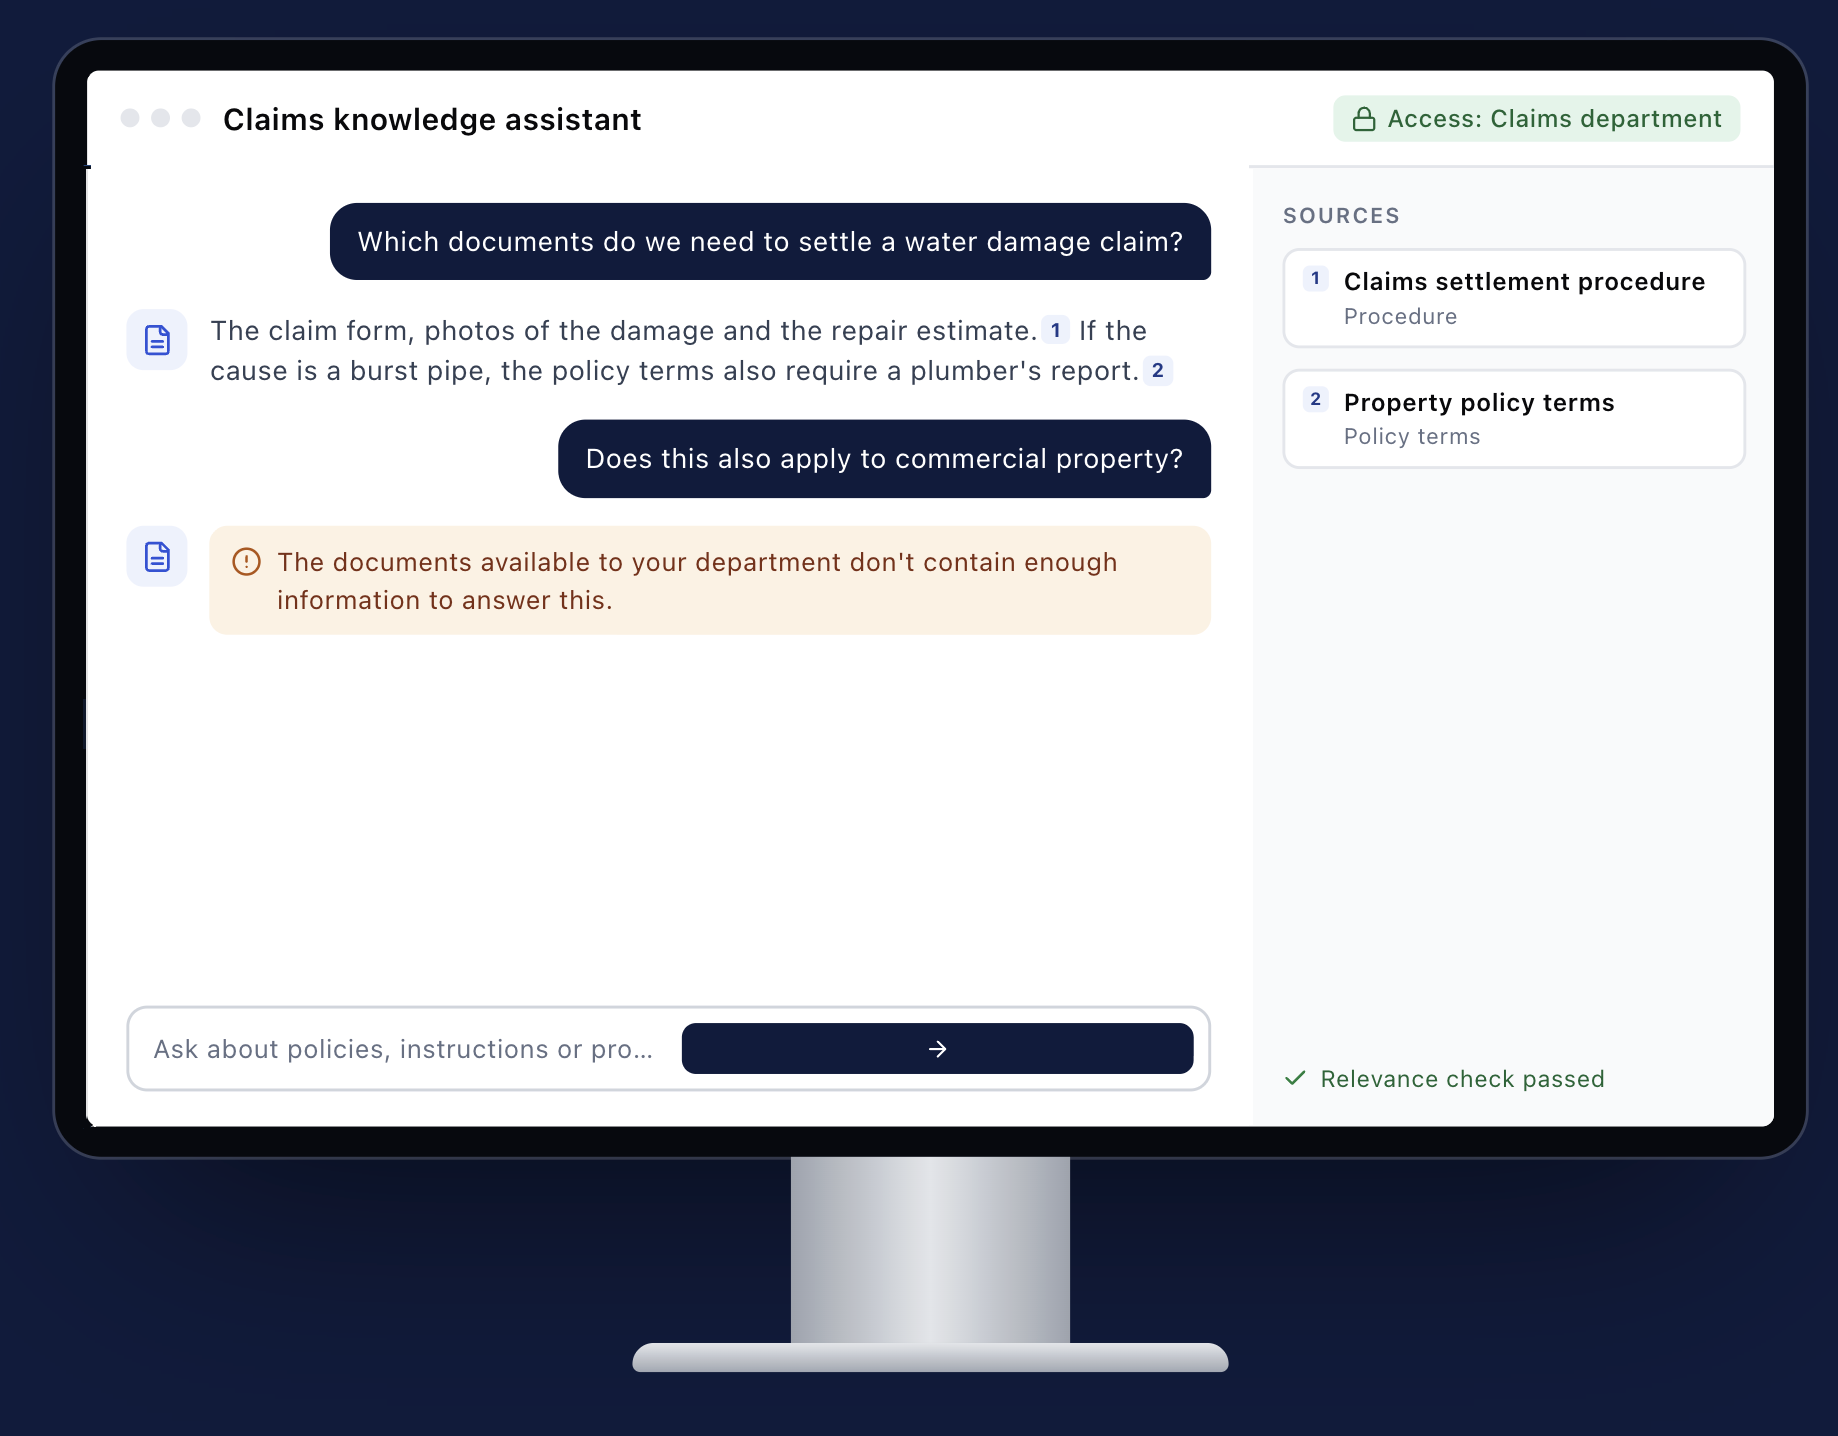
12.000 documenti · 4 persone · 10 settimane
Parliamo del vostro progetto RAGOgni fase si chiude con qualcosa che potete aprire, testare e approvare.
I vostri responsabili dei dati confermano fonti, lacune e regole di accesso
I vostri utenti lo provano sul campo con domande reali
Il vostro revisore lo approva secondo criteri concordati
I vostri ingegneri lo revisionano; la titolarità è stabilita nel contratto
Il vostro team la revisiona e prende in carico le attività concordate
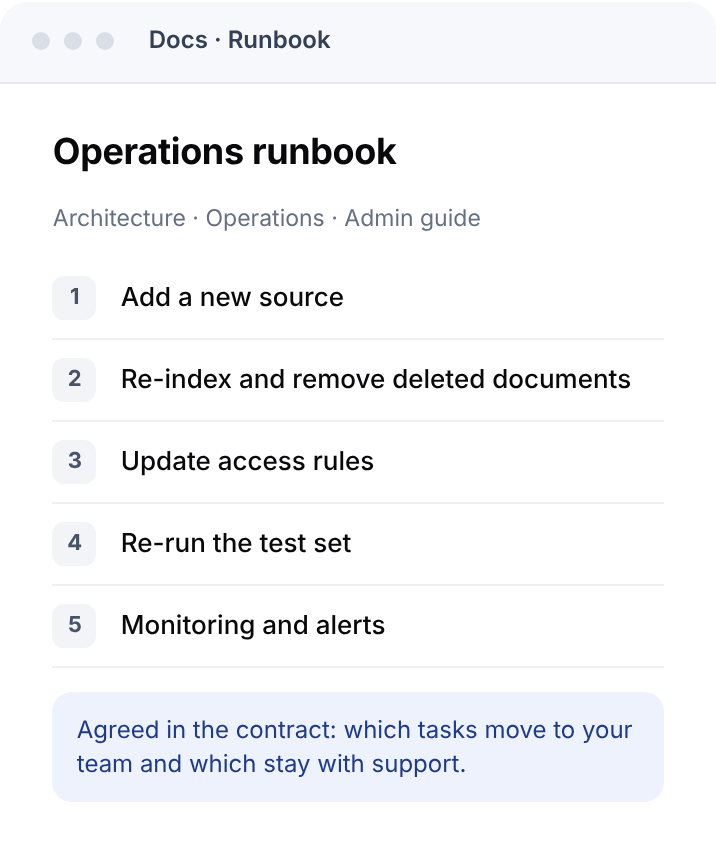
“La qualità del passaggio di consegne ci ha colpito. Abbiamo ricevuto i test, la documentazione e un processo chiaro per aggiornare la knowledge base. I nostri ingegneri hanno preso confidenza con il sistema e ne hanno assunto il supporto senza dipendere a lungo dal fornitore.”
Due sistemi RAG con la stessa lista di funzionalità possono richiedere quantità di lavoro molto diverse, perché la maggior parte dell'impegno sta nei dati che ci sono dietro. Per questo stimiamo ogni progetto a partire dai suoi input, non da un listino.
Quali fonti, quanti utenti, regole di accesso, dove gira, quali strumenti e quanto vi costa una risposta sbagliata.
Appena condividete questi requisiti, il nostro Solutions Architect vi invia una stima delle ore per modulo.
Dopo l'audit dei dati, la stima viene aggiornata con quanto emerso dalle vostre fonti.
Volume di query e scelta del modello sono ciò che incide di più su questa cifra, quindi la modelliamo sul vostro utilizzo previsto come parte della stima.
Il testo pulito in un'unica wiki è facile da indicizzare. PDF scansionati, fogli di calcolo e tabelle complesse richiedono parsing e controlli aggiuntivi.
Duplicati, versioni obsolete e documenti in contraddizione vanno ripuliti o classificati, altrimenti il sistema risponderà dal documento sbagliato.
Portare i permessi da SharePoint o da un CRM nel retrieval è un lavoro di ingegneria a sé.
Un assistente di supporto sulla documentazione pubblica richiede meno revisione esperta di uno strumento su cui fa affidamento il vostro ufficio legale.
Ogni sistema di destinazione aggiunge lavoro di autenticazione, interfaccia e manutenzione.
Un setup su cloud gestito di solito si avvia più rapidamente di un cloud privato o di un deployment on-premises con un modello self-hosted.
Incide più sul dimensionamento dell'infrastruttura e sui costi d'uso del modello che sull'impegno di sviluppo.
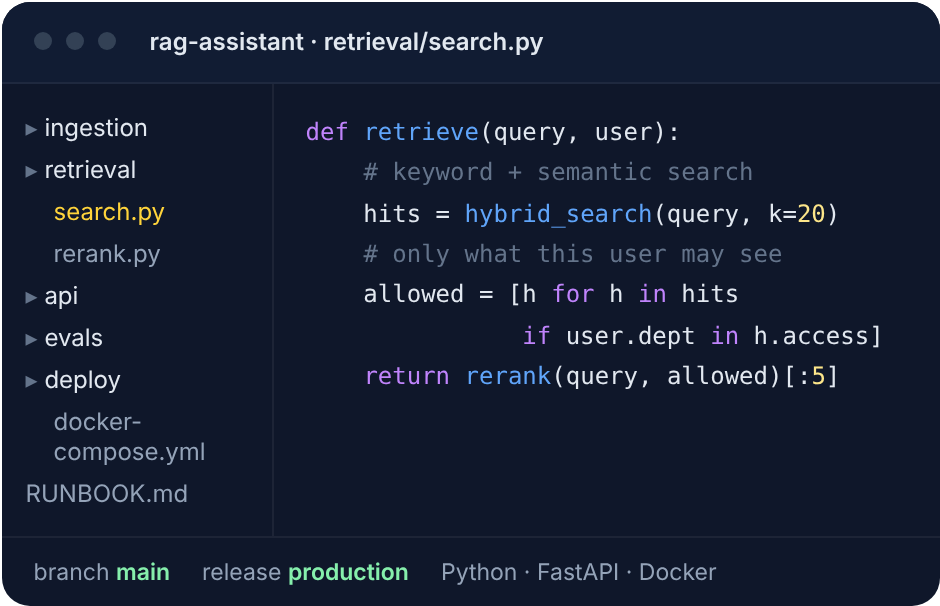
L'assistente assicurativo descritto sopra copriva 12.000 documenti di tre tipi con accesso per reparto e ha richiesto 10 settimane a un team di quattro persone.
Un progetto con meno fonti e senza regole di accesso richiede meno. Uno con più integrazioni, sicurezza più rigorosa o un modello self-hosted richiede di più.
Una volta in funzione, pagate l'uso dell'LLM (a token tramite API, oppure hosting GPU se il modello gira nel vostro ambiente), l'hosting del database vettoriale, la capacità di calcolo per i job di ingestione e sincronizzazione, il monitoraggio e i log. A questo si aggiunge il tempo di supporto per correggere problemi di retrieval e ripetere i test quando cambiano i contenuti.
Per una visione più ampia dei budget AI, leggete la nostra analisi del costo di sviluppo di un'app AI.
I nuovi progetti di solito attraversano quattro fasi. Ognuna si chiude con una vostra decisione prima che inizi la successiva. Se avete già un sistema RAG, il lavoro parte da una sua revisione e le fasi si adattano a ciò che va corretto.
Accesso a fonti di esempio, un responsabile per ogni fonte, un referente per la sicurezza
Esperti della materia che scrivono le domande di test e valutano le risposte
Requisiti di sicurezza e infrastruttura, accesso ai sistemi con cui integriamo
Un responsabile per ogni fonte e un canale per il feedback degli utenti
Non dovete impegnarvi subito in uno sviluppo completo. La collaborazione può iniziare con la sola discovery, con un pilota o con la revisione di un sistema RAG che già usate.
Sono i vostri esperti a definire cos’è una risposta corretta. Nulla va in produzione finché il vostro referente non approva i risultati.
Domande reali da ticket, chat e log di ricerca, con risposte attese approvate dai vostri esperti.
Compresi i casi in cui il RAG si rompe: nessuna risposta nelle fonti, documenti obsoleti, file riservati.
Andare in produzione, correggere, restringere il perimetro o fermarsi. Molto più economico dopo un pilota che dopo uno sviluppo completo.
“Il pilota ha fatto emergere le lacune, così abbiamo messo ordine nei documenti e affinato la ricerca. Ora i nuovi dipendenti trovano più in fretta ciò che serve e i manager passano meno tempo a spiegare sempre le stesse cose.”
Lo sviluppo su misura ha senso quando le vostre fonti sono complesse o sensibili, quando gli utenti hanno bisogno di diritti di accesso diversi o quando il sistema deve girare nel vostro ambiente o dentro il vostro prodotto. Nei casi più semplici, una piattaforma RAG gestita porta più in fretta a un risultato funzionante.
Un sistema su misura usa spesso componenti gestiti, come un database vettoriale in hosting o un'API LLM commerciale; l'assistente assicurativo descritto sopra gira su OpenAI API e AWS.
Cambia il comportamento del modello, ad esempio il tono, il formato di output o la gestione dei termini di settore, ma non dà al modello accesso ai vostri documenti attuali. Potete combinarlo con il RAG quando vi servono sia conoscenze aggiornate sia uno stile di risposta specifico.
Se il vostro progetto va oltre il retrieval, ad esempio la scelta del modello o il fine-tuning, consultate i nostri servizi di sviluppo LLM.
Queste domande vi aiutano a confrontare i fornitori su prove concrete anziché su promesse.
Potete mostrare risultati misurati di un progetto paragonabile e spiegare come sono stati misurati?
Chi decide cosa sia una risposta corretta durante i test, e cosa succede se il sistema non rispetta i criteri?
Come vengono salvati e verificati i permessi delle fonti al momento della query?
Dove girerà il sistema e dove saranno conservati i nostri dati e log?
Quanto costerà al mese farlo funzionare con il nostro utilizzo previsto?
A chi appartengono il codice e l'indice dopo il passaggio di consegne?
Proprietà, prontezza dei dati, integrazione, scelta dello stack e supporto dopo il lancio.
I vostri dati restano vostri in ogni fase. La proprietà di codice sorgente, configurazione e indice viene stabilita nel contratto prima di iniziare, così sapete cosa riceverete al passaggio di consegne.
No. La maggior parte dei team parte da fonti disordinate. All'inizio conta sapere quali documenti fanno fede e chi ne è responsabile. L'audit dei dati mostra cosa va ripulito, e la pulizia che incide sulla qualità delle risposte entra nel perimetro del progetto.
Sì. Il retrieval e la generazione delle risposte possono essere esposti come un'API chiamata dal vostro prodotto. Le principali questioni di progettazione sono come la vostra app trasmette l'identità dell'utente, perché valgano i permessi, e come le risposte mostrano le fonti nella vostra interfaccia.
Scegliamo dopo l'audit dei dati, in base a dove possono essere elaborati i vostri dati, al volume di query previsto e ai risultati sul vostro set di test. L'assistente assicurativo descritto sopra usava Python, FastAPI, LangChain, PostgreSQL con pgvector e OpenAI API su AWS. Se i dati non possono uscire dal vostro ambiente, un modello open-source ospitato sulla vostra infrastruttura sostituisce l'API esterna.
Il supporto copre il monitoraggio, la correzione di problemi di sincronizzazione e retrieval e la riesecuzione del set di test dopo modifiche alle fonti o al modello. Aggiungere nuove fonti o casi d'uso è lavoro di sviluppo e viene stimato a parte. Perimetro e tempi di risposta del supporto sono fissati in un accordo separato.
Per ricevere una stima, inviateci l'elenco delle fonti che il sistema deve usare, il numero previsto di utenti ed eventuali requisiti di sicurezza o deployment.