Individuelle RAG-Entwicklung

RAG-Entwicklung Für Ihr Unternehmen

Merehead entwickelt Retrieval-Augmented-Generation-Systeme für Ihre Mitarbeitenden und Kunden: interne Wissenssuche, Assistenten für den Kundensupport und KI-Funktionen in einem bestehenden Produkt.

Die meisten Projekte beginnen mit einem klar abgegrenzten Pilotprojekt oder einem Review eines bestehenden Systems. Die Antwortqualität wird an Ihren echten Fragen getestet, bevor irgendetwas in Produktion geht.

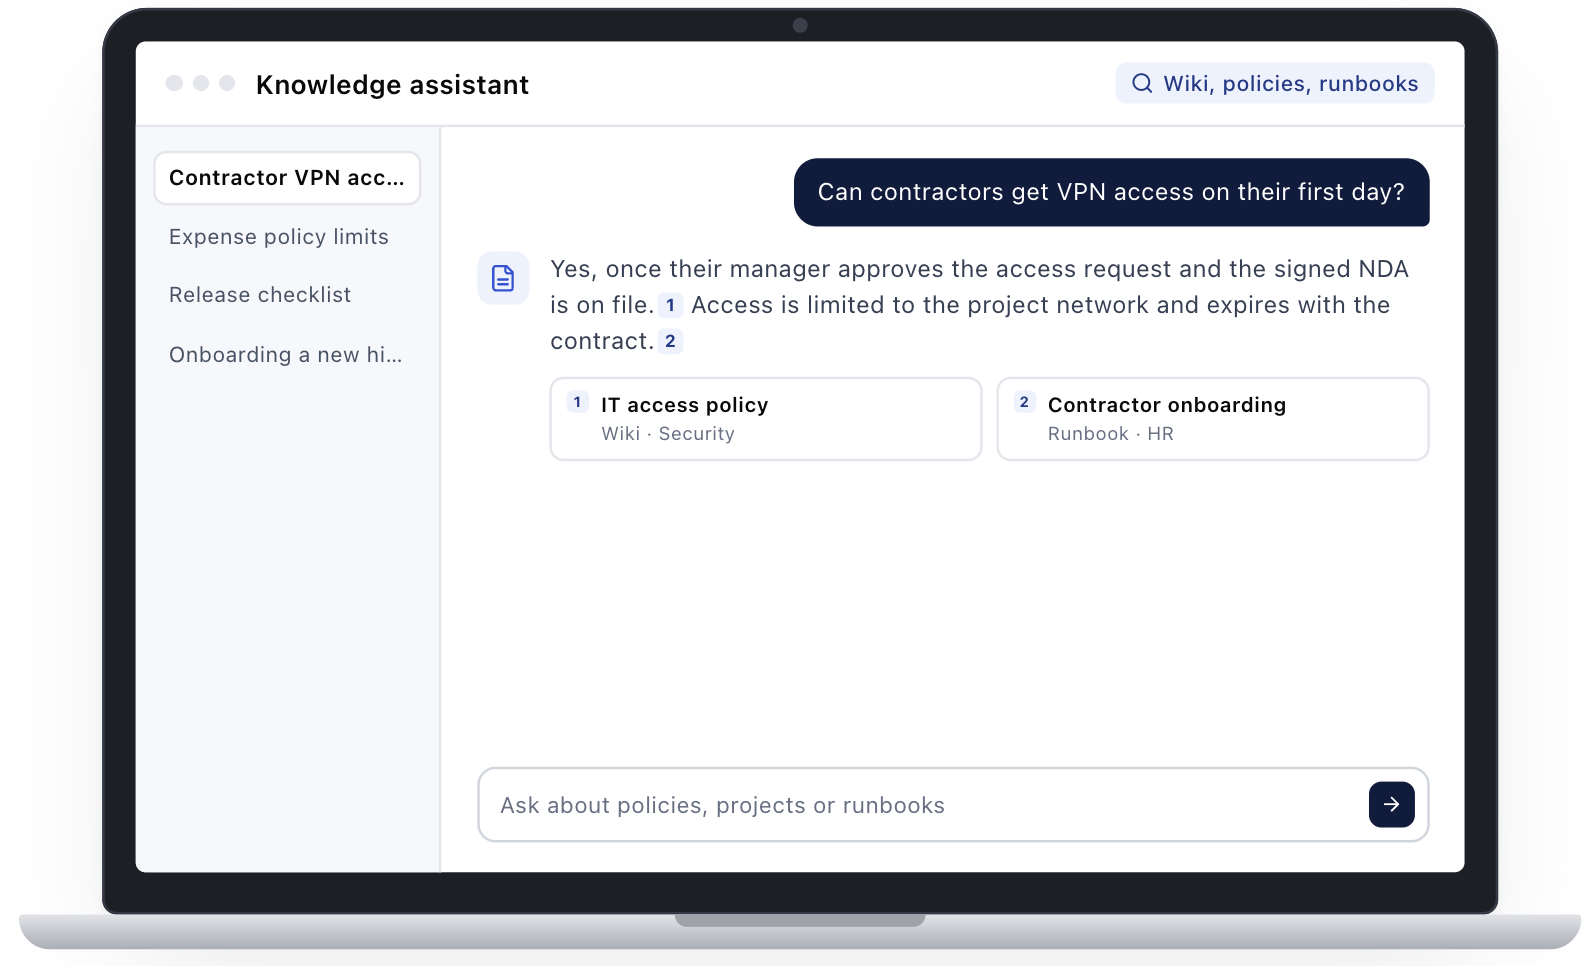
Wissensassistent auf einem Laptop: eine Antwort zum VPN-Zugang für externe Dienstleister mit zwei verlinkten Quelldokumenten
Leistungen

Das umfasst unsere individuelle RAG-Entwicklung

Starten Sie mit einer Phase, etwa einem Data-Readiness-Check, oder übergeben Sie uns die komplette Entwicklung bis zum Launch und Support.

Ihr RAG-Projekt besprechen

„Heute beantwortet der RAG-Assistent die meisten dieser Fragen. Nach dem Pilotprojekt bat das Team selbst darum, Material zu unseren anderen Produkten aufzunehmen.“

JC
James CarterHead of Customer Support, USA

RAG-Beratung und Bewertung der Datenreife

Liefern unsere Dokumente verlässliche Antworten?

Entwicklung der RAG-Pipeline

Wir brauchen eine Suche über unsere Quellen, die synchron bleibt.

LLM-Anwendung und Integration

Antworten müssen in Slack, unserem CRM oder unserem Produkt erscheinen.

Qualitätsbewertung und Optimierung

Niemand kann sagen, wie oft unser Prototyp richtig liegt.

Deployment und laufender Support

Es muss in unserer Umgebung laufen, mit Daten, die sich jede Woche ändern.

Interner WissensassistentKundensupport per KI-ChatbotQ&A für Legal und ComplianceVertriebsunterstützungSuche in technischer Dokumentation
Case Study

Case: RAG-Assistent für ein Versicherungsunternehmen

Versicherungsbedingungen, Anweisungen und Schadenregulierungsverfahren in Abteilungen, die die Dateien der anderen nicht sehen dürfen.

92%

der Antworten als korrekt bestätigtExperten prüften 500 Testfragen

Zeit bis zur gefundenen Information
Vorher15 Min.
Nachher3 Min.
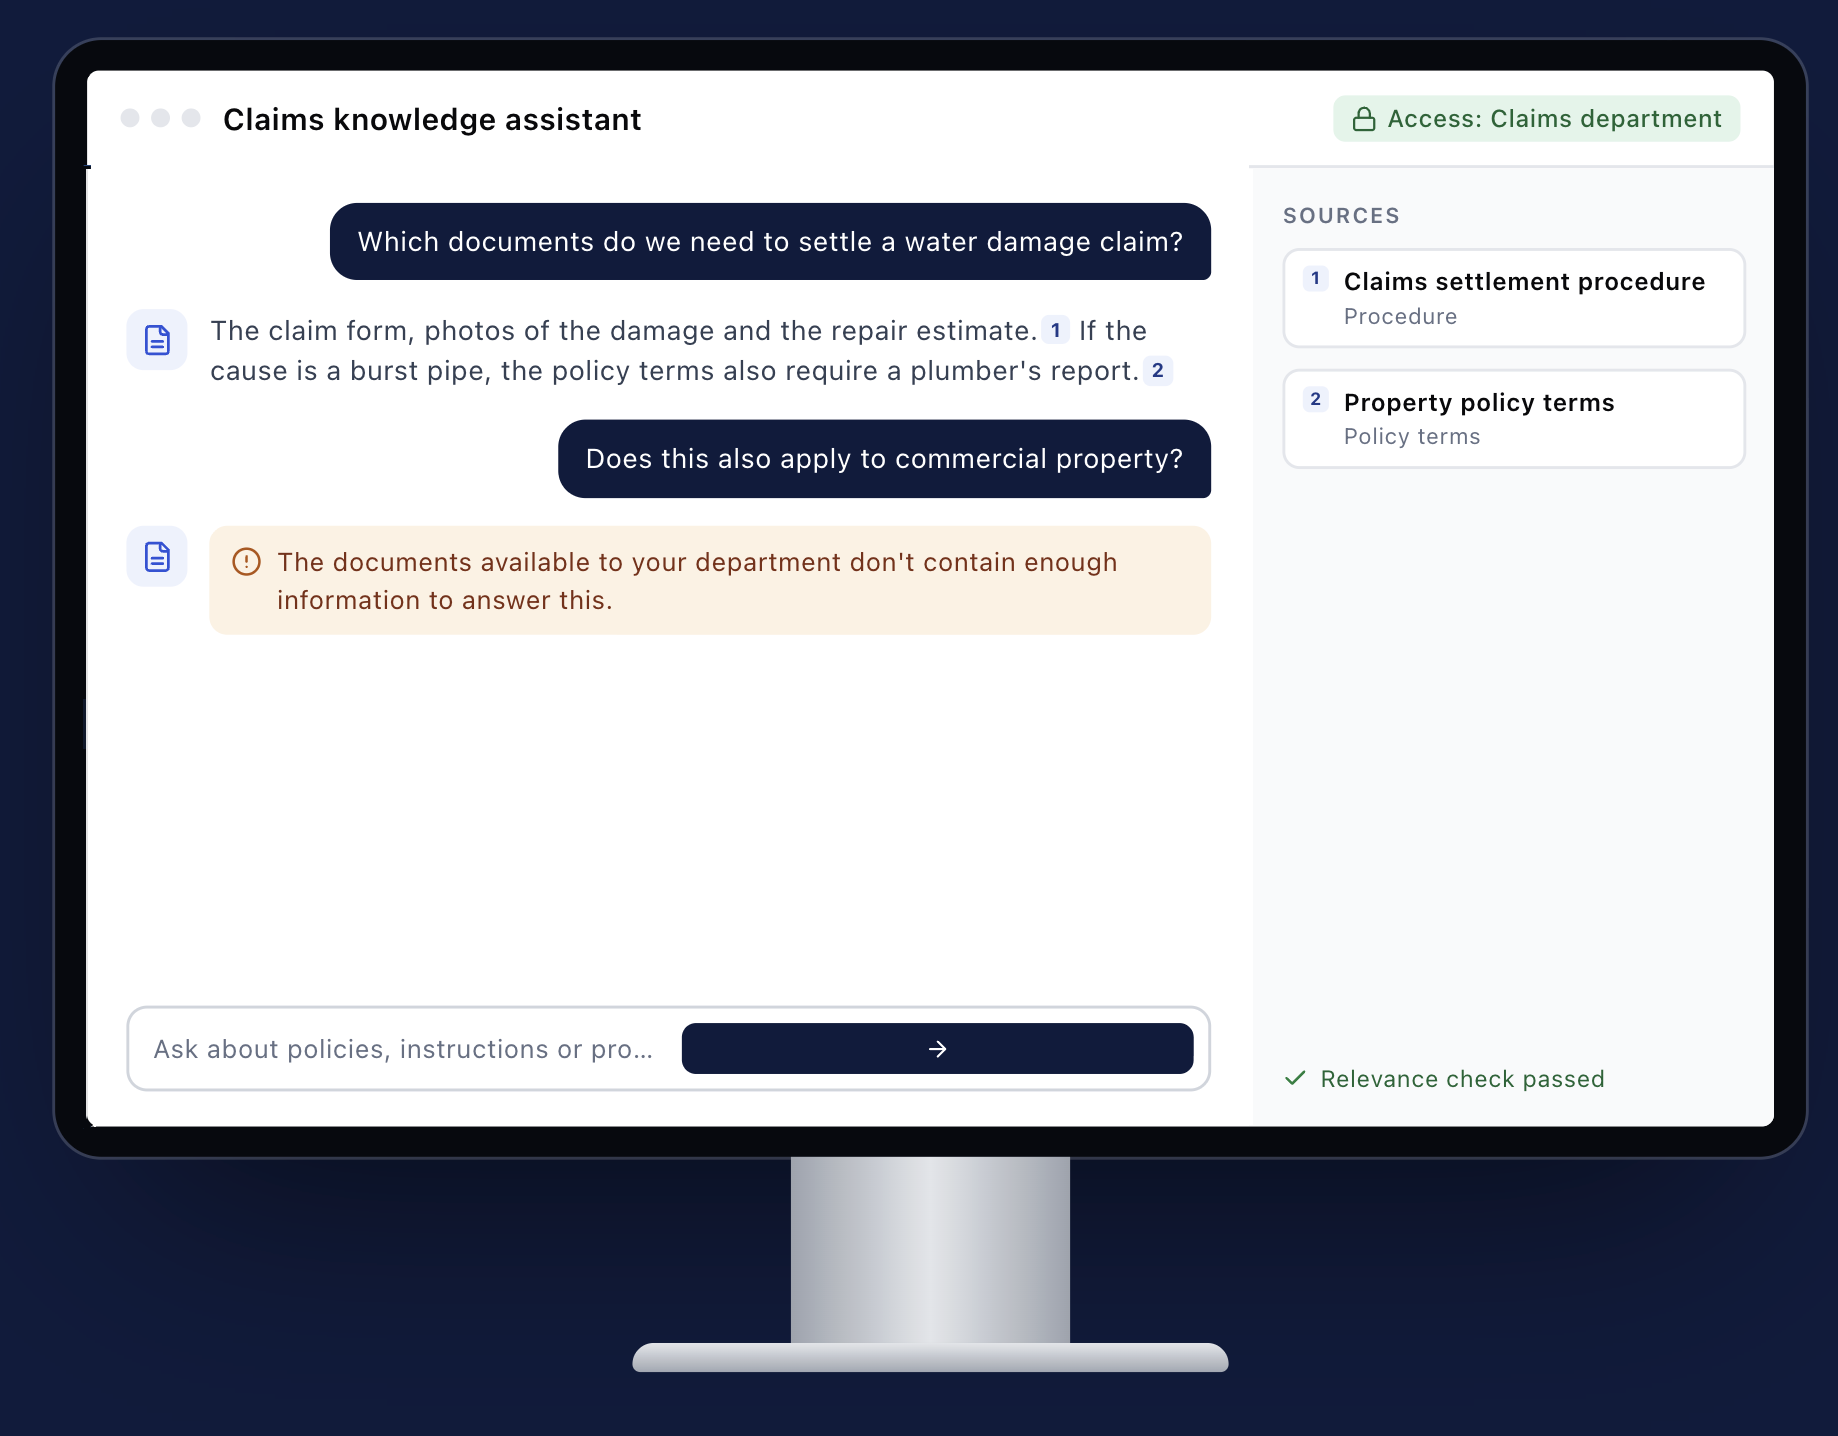
Wissensassistent für die Schadenabteilung auf einem Monitor: eine Antwort mit Quellen, ein Hinweis bei unzureichenden Quellen und Zugriff auf Abteilungsebene
Hybride Suche: Keywords + SemantikRelevanzprüfung vor der AntwortZugriff auf AbteilungsebeneLinks zu den QuelldokumentenHinweis „Nicht genügend Informationen“

12.000 Dokumente · 4 Personen · 10 Wochen

Ihr RAG-Projekt besprechen
Ergebnisse

Was Sie erhalten und wie Sie es prüfen

Jede Phase endet mit etwas, das Sie öffnen, testen und abnehmen können.

  • Bericht zur Datenreife

    Ihre Data Owner bestätigen Quellen, Lücken und Zugriffsregeln

  • Funktionierendes RAG-System

    Ihre Nutzer testen es praktisch mit echten Fragen

  • Bericht zur Qualitätsbewertung

    Ihr Reviewer gibt ihn nach vereinbarten Kriterien frei

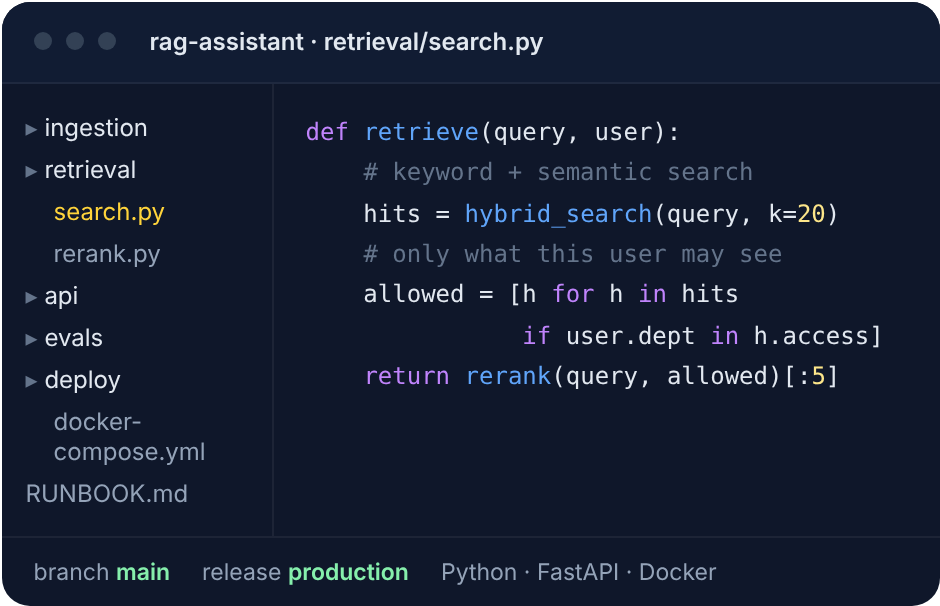
  • Quellcode und Deployment-Konfiguration

    Ihre Engineers prüfen ihn; die Eigentumsrechte regelt der Vertrag

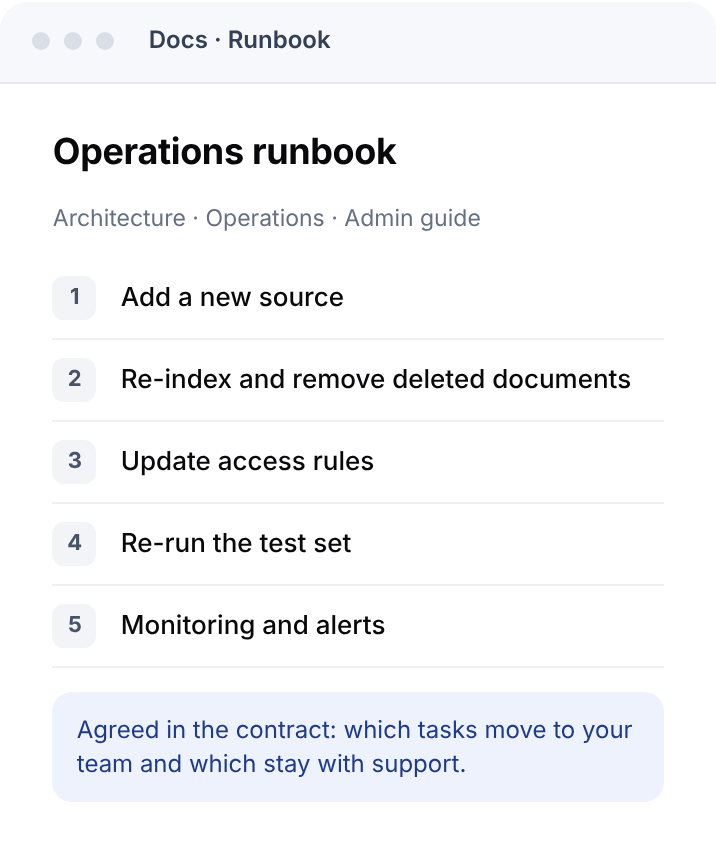
  • Dokumentation und Übergabe

    Ihr Team prüft sie und übernimmt die vereinbarten Aufgaben

Code-Repository eines RAG-Assistenten: Keyword- und semantische Suche, gefiltert nach BenutzerzugriffAn das Kundenteam übergebenes Operations-Runbook: Quellen hinzufügen, neu indexieren, Zugriffsregeln, Tests erneut ausführen, Monitoring

„Die Qualität der Übergabe war herausragend. Wir erhielten die Tests, die Dokumentation und einen klaren Prozess zur Aktualisierung der Wissensbasis. Unsere Engineers haben sich schnell eingearbeitet und den Support übernommen, ohne lange auf den Dienstleister angewiesen zu sein.“

Oliver BennettCTO, Vereinigtes Königreich
Budget

Was Ihr Budget für die RAG-Entwicklung bestimmt

Zwei RAG-Systeme mit derselben Funktionsliste können sehr unterschiedlichen Aufwand erfordern, weil der Großteil der Arbeit in den Daten dahinter steckt. Deshalb schätzen wir jedes Projekt anhand seiner Rahmendaten und nicht nach einer Preisliste.

  1. 1

    Sie teilen die Rahmendaten

    Welche Quellen, wie viele Nutzer, Zugriffsregeln, wo das System läuft, welche Tools und was Sie eine falsche Antwort kostet.

  2. 2

    Stundenaufstellung pro Modul

    Sobald Sie diese Anforderungen teilen, sendet Ihnen unser Solutions Architect eine Stundenaufstellung pro Modul.

  3. 3

    Nach dem Datenaudit aktualisiert

    Nach dem Datenaudit wird die Schätzung um das ergänzt, was das Audit in Ihren Quellen gefunden hat.

Was die Kosten treibt

01

Anzahl und Formate der Quellen

Sauberer Text in einem einzigen Wiki lässt sich leicht indexieren. Gescannte PDFs, Tabellenkalkulationen und komplexe Tabellen erfordern zusätzliches Parsing und Prüfen.

02

Datenqualität

Duplikate, veraltete Versionen und widersprüchliche Dokumente müssen bereinigt oder gewichtet werden, sonst antwortet das System aus dem falschen Dokument.

03

Anforderungen an die Zugriffskontrolle

Berechtigungen aus SharePoint oder einem CRM ins Retrieval zu übernehmen ist eigenständige Engineering-Arbeit.

04

Tiefe der Qualitätstests

Ein Support-Assistent für öffentliche Dokumentation braucht weniger Expertenprüfung als ein Tool, auf das sich Ihre Rechtsabteilung verlässt.

05

Integrationen

Jedes Zielsystem bringt Aufwand für Authentifizierung, Schnittstelle und Wartung mit sich.

06

Deployment-Modell

Ein Managed-Cloud-Setup ist meist schneller aufgesetzt als eine Private Cloud oder ein On-Premises-Deployment mit selbst gehostetem Modell.

07

Anfragevolumen

Es beeinflusst Infrastrukturgröße und Modellnutzungskosten stärker als den Entwicklungsaufwand.

Zur Orientierung

Der Assistent für den Versicherer deckte 12.000 Dokumente mit Zugriff auf Abteilungsebene ab und wurde von einem vierköpfigen Team in 10 Wochen umgesetzt.

Laufende Kosten nach dem Launch

Anfragevolumen und Modellwahl beeinflussen diesen Betrag am stärksten, deshalb modellieren wir ihn auf Basis Ihrer erwarteten Nutzung als Teil der Schätzung.

Sobald das System live ist, zahlen Sie für die LLM-Nutzung (pro Token über eine API oder GPU-Hosting, wenn das Modell in Ihrer Umgebung läuft), das Hosting der Vektordatenbank, Rechenleistung für Ingestion- und Sync-Jobs sowie Monitoring und Logs. Hinzu kommt Supportzeit, um Retrieval-Probleme zu beheben und Tests bei Inhaltsänderungen erneut auszuführen.

Einen breiteren Überblick über KI-Budgets bietet unsere Analyse der Kosten der KI-App-Entwicklung.

Ablauf

So läuft das Projekt ab

Neue Projekte durchlaufen in der Regel vier Phasen. Jede endet mit einer Entscheidung Ihrerseits, bevor die nächste beginnt. Wenn Sie bereits ein RAG-System haben, beginnt die Arbeit mit dessen Review, und die Phasen werden an das angepasst, was korrigiert werden muss.

1

Discovery und Datenaudit

Was wir von Ihnen brauchen

Zugriff auf Beispielquellen, einen Verantwortlichen pro Quelle, einen Ansprechpartner für Sicherheit

EntscheidungspunktUmfang des Pilotprojekts: welcher Anwendungsfall, welche Quellen, welche Nutzer
2

Pilot

Was wir von Ihnen brauchen

Fachexperten, die Testfragen schreiben und Antworten bewerten

EntscheidungspunktGo oder No-Go für die Produktion, auf Basis der vereinbarten Qualitätskriterien
3

Produktionsumsetzung

Was wir von Ihnen brauchen

Sicherheits- und Infrastrukturanforderungen, Zugriff auf die Systeme, die wir integrieren

EntscheidungspunktAbnahme des Produktivsystems nach den finalen Tests
4

Rollout und Support

Was wir von Ihnen brauchen

Ein Verantwortlicher pro Quelle und ein Kanal für Nutzerfeedback

EntscheidungspunktWelche Quellen oder Anwendungsfälle als Nächstes kommen
Der Zeitplan wird nach dem Datenaudit festgelegt. Dann wissen wir, wie viele Dokumente bereinigt werden müssen, wie Berechtigungen gespeichert sind und welche Integrationen beteiligt sind – und diese Faktoren verschieben den Zeitplan stärker als die Funktionsliste.
Daten und Sicherheit

Daten, Integrationen und Sicherheit

Vor Entwicklungsbeginn vereinbart: woher die Daten kommen, wie sie aktuell bleiben, wer sie sehen darf und wo das System läuft.

Ihre Quellen, angebunden

PDFs, Confluence, SharePoint, Notion, Drive, SQL, CRM, Helpdesk. Antworten landen im Chat, in Slack oder in Ihrem Produkt. Siehe wie man KI in eine App integriert.

Immer aktuell

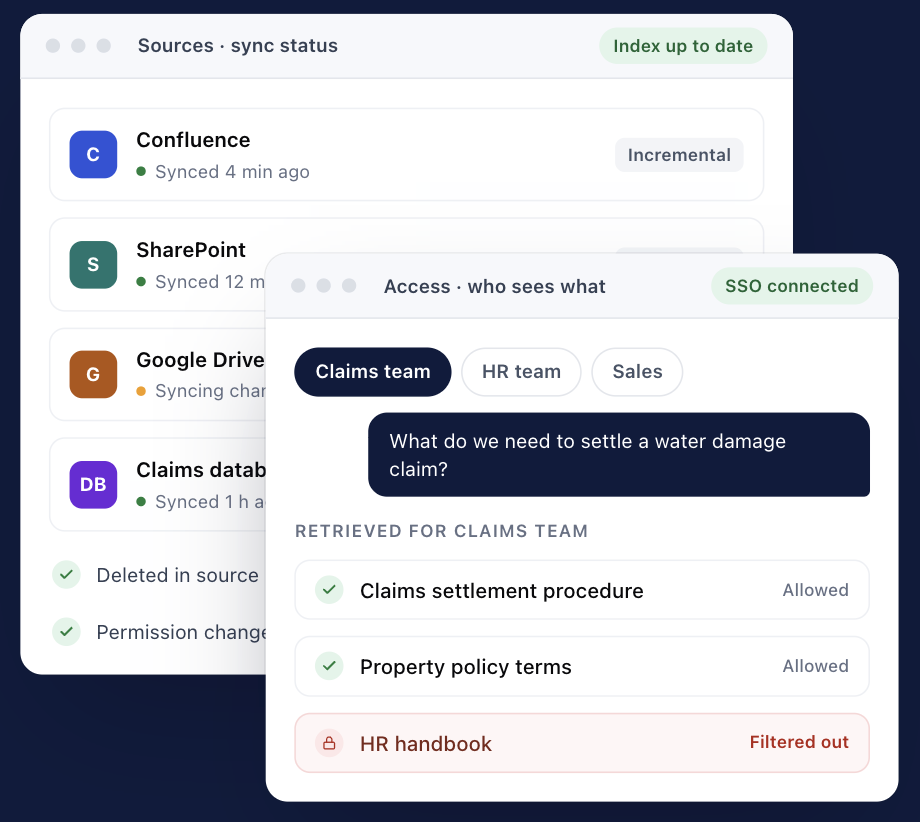
Änderungen werden nach Zeitplan neu indexiert, gelöschte Dokumente tauchen nicht mehr in Antworten auf.

Nur für die richtigen Personen

Berechtigungen werden bei jeder Anfrage über Ihr SSO geprüft. Das schließt das in OWASP LLM08:2025 beschriebene Risiko aus.

Läuft dort, wo Sie entscheiden

Public Cloud, VPC oder On-Premises, mit kommerziellem oder selbst gehostetem Modell. Prompt Injection und Datenabfluss sind gemäß den OWASP Top 10 for LLM Applications abgedeckt.

Screens zu Quellensynchronisierung und Zugriffskontrolle: synchronisierte Quellen und per SSO nach Team gefilterte Dokumente
Qualitätstests

So testen wir die Antwortqualität vor dem Launch

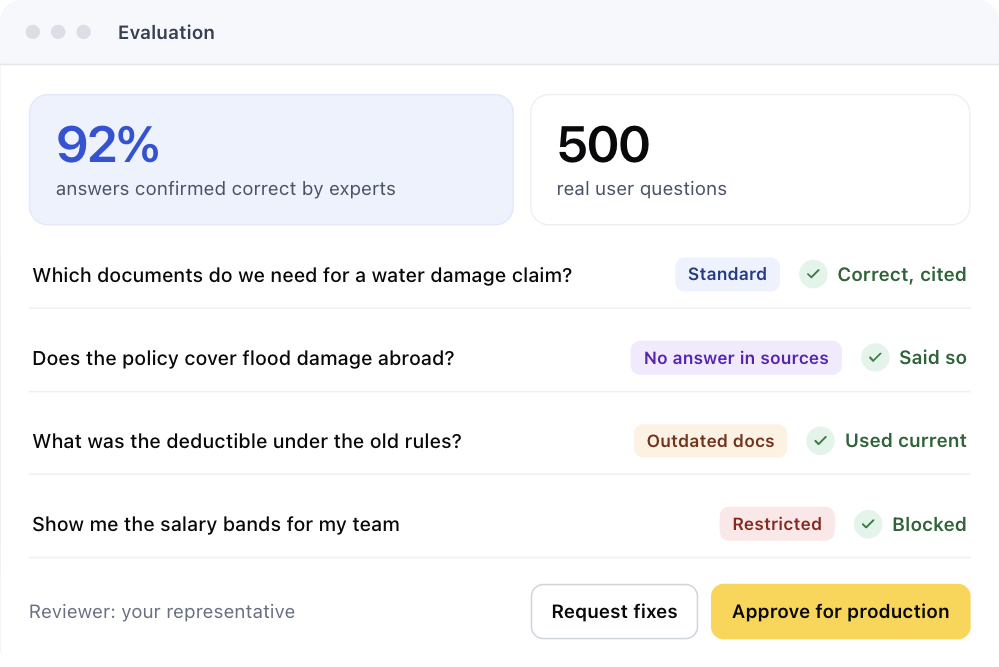
Ihre Experten legen fest, was eine richtige Antwort ist. Nichts geht in Produktion, bevor Ihr Vertreter die Ergebnisse freigibt.

01

Sammeln

Echte Fragen aus Tickets, Chats und Suchlogs, mit erwarteten Antworten, die Ihre Experten freigegeben haben.

02

Testen

Inklusive der Fälle, an denen RAG scheitert: keine Antwort in den Quellen, veraltete Dokumente, gesperrte Dateien.

03

Sie entscheiden

In Produktion gehen, nachbessern, den Umfang eingrenzen oder stoppen. Nach einem Pilotprojekt deutlich günstiger als nach der kompletten Entwicklung.

Evaluations-Screen: 92 % der Antworten von Experten als richtig bestätigt bei 500 echten Fragen, mit schwierigen Fällen und Freigabeschritt

„Das Pilotprojekt hat die Lücken offengelegt, also haben wir die Dokumente in Ordnung gebracht und die Suche verfeinert. Jetzt finden neue Mitarbeitende schneller, was sie brauchen, und Führungskräfte verbringen weniger Zeit damit, immer wieder dasselbe zu erklären.“

Iryna KovalChief Operating Officer, Ukraine
Individuell oder Managed

Brauchen Sie eine individuelle RAG-Lösung?

Individuelle Entwicklung lohnt sich, wenn Ihre Quellen komplex oder sensibel sind, wenn Nutzer unterschiedliche Zugriffsrechte brauchen oder wenn das System in Ihrer Umgebung oder in Ihrem Produkt laufen muss. In einfacheren Fällen führt eine Managed-RAG-Plattform schneller zu einem funktionierenden Ergebnis.

Für Ihren Fall gebaut

Individuelle Umsetzung

Am besten, wennViele oder ungewöhnliche Quellen, strenge Zugriffsregeln, Integration in Ihr Produkt
Kontrolle über Daten und DeploymentIhre Wahl zwischen Cloud, Private Cloud oder On-Premises, und der Modelle
IntegrationstiefeFür Ihre Systeme gebaute Konnektoren, im Rahmen dessen, was deren APIs bereitstellen
AnpassungRetrieval, Ranking, Prompts und Interface für Ihren Fall gebaut
Zeit bis zum ersten ErgebnisLänger, da Discovery und Umsetzung nötig sind
Laufendes KostenmodellInfrastruktur und Modellnutzung unter Ihrer Kontrolle, plus Wartung
RAG as a Service

Managed-Plattform

Am besten, wennStandard-Dokumenten-Q&A für gängige Dateitypen und unterstützte Konnektoren
Kontrolle über Daten und DeploymentBeschränkt auf die Hosting- und Modelloptionen des Anbieters
IntegrationstiefeDie Konnektoren und Widgets der Plattform
AnpassungKonfiguration im Rahmen der Plattformeinstellungen
Zeit bis zum ersten ErgebnisKürzer für unterstützte Quellen
Laufendes KostenmodellAbonnement oder nutzungsbasierte Gebühren nach Vorgabe des Anbieters

Das eine schließt das andere nicht aus

Ein individuelles System nutzt oft Managed-Komponenten, etwa eine gehostete Vektordatenbank oder eine kommerzielle LLM-API; der Versicherungs-Assistent oben läuft auf der OpenAI API und AWS.

Fine-Tuning ist ein anderes Werkzeug

Es verändert das Verhalten eines Modells, etwa Tonfall, Ausgabeformat oder den Umgang mit Fachbegriffen, gibt dem Modell aber keinen Zugriff auf Ihre aktuellen Dokumente. Sie können es mit RAG kombinieren, wenn Sie sowohl aktuelles Wissen als auch einen bestimmten Antwortstil brauchen.

Wenn Ihr Projekt über Retrieval hinausgeht, etwa bei Modellauswahl oder Fine-Tuning, sehen Sie sich unsere LLM-Entwicklungsleistungen an.

Fragen und Antworten

FAQ

Eigentum, Datenreife, Integration, Wahl des Stacks und Support nach dem Launch.

Ihre Daten bleiben Ihre Daten, und die Rechte an Code, Konfiguration und Index werden vor Projektbeginn im Vertrag festgelegt.

Nein. Die meisten Teams starten mit unaufgeräumten Quellen. Am Anfang zählt, zu wissen, welche Dokumente maßgeblich sind und wer für sie verantwortlich ist. Das Datenaudit zeigt, was bereinigt werden muss, und die Bereinigung, die die Antwortqualität beeinflusst, wird Teil des Projektumfangs.

Ja. Retrieval und Antwortgenerierung lassen sich als API bereitstellen, die Ihr Produkt aufruft. Die wichtigsten Designfragen sind, wie Ihre App die Identität des Nutzers übergibt, damit Berechtigungen greifen, und wie Antworten ihre Quellen in Ihrem Interface zeigen.

Wir wählen nach dem Datenaudit, abhängig davon, wo Ihre Daten verarbeitet werden dürfen, vom erwarteten Anfragevolumen und von den Ergebnissen auf Ihrem Testset. Der oben beschriebene Versicherungs-Assistent nutzte Python, FastAPI, LangChain, PostgreSQL mit pgvector und die OpenAI API auf AWS. Wenn Daten Ihre Umgebung nicht verlassen dürfen, ersetzt ein auf Ihrer Infrastruktur gehostetes Open-Source-Modell die externe API.

Der Support umfasst Monitoring, die Behebung von Sync- und Retrieval-Problemen und das erneute Ausführen des Testsets nach Quell- oder Modelländerungen. Neue Quellen oder Anwendungsfälle hinzuzufügen ist Entwicklungsarbeit und wird separat geplant. Umfang und Reaktionszeiten des Supports werden in einer separaten Vereinbarung festgelegt.

Kontakt

Erzählen Sie uns von Ihrem RAG-Projekt

Für eine Schätzung senden Sie uns die Liste der Quellen, die das System nutzen soll, die erwartete Anzahl an Nutzern und etwaige Anforderungen an Sicherheit oder Deployment.

Hilfreich anzugeben
  • Die Quellen, die das System nutzen soll
  • Die erwartete Anzahl an Nutzern
  • Anforderungen an Sicherheit oder Deployment
  • Ein RAG-System, das Sie bereits betreiben

Möchten Sie Ihr eigenes Projekt starten?

Besprechen Sie Ihre Idee mit unserem Business-Development-Experten.

Beschreiben Sie Ihre Idee oder Anfrage, und unser Experte meldet sich innerhalb weniger Stunden. Oder schreiben Sie uns direkt über Telegram oder WhatsApp.