Cadrage et audit des données
Un accès à des sources d'exemple, un responsable par source, un interlocuteur sécurité
Services
Depuis plus de 10 ans, nous développons des projets financiers basés sur la blockchain : plateformes d'échange crypto centralisées et décentralisées, bots crypto, passerelles de paiement, tokenisation immobilière, projets DeFi et NFT.
AI & ML
Depuis 2023, nous développons de l'IA pour les entreprises : IA et LLM sur mesure, agents IA, chatbots et IA d'entreprise connectée à vos données, produits et processus.
Développement RAG Pour Votre Entreprise
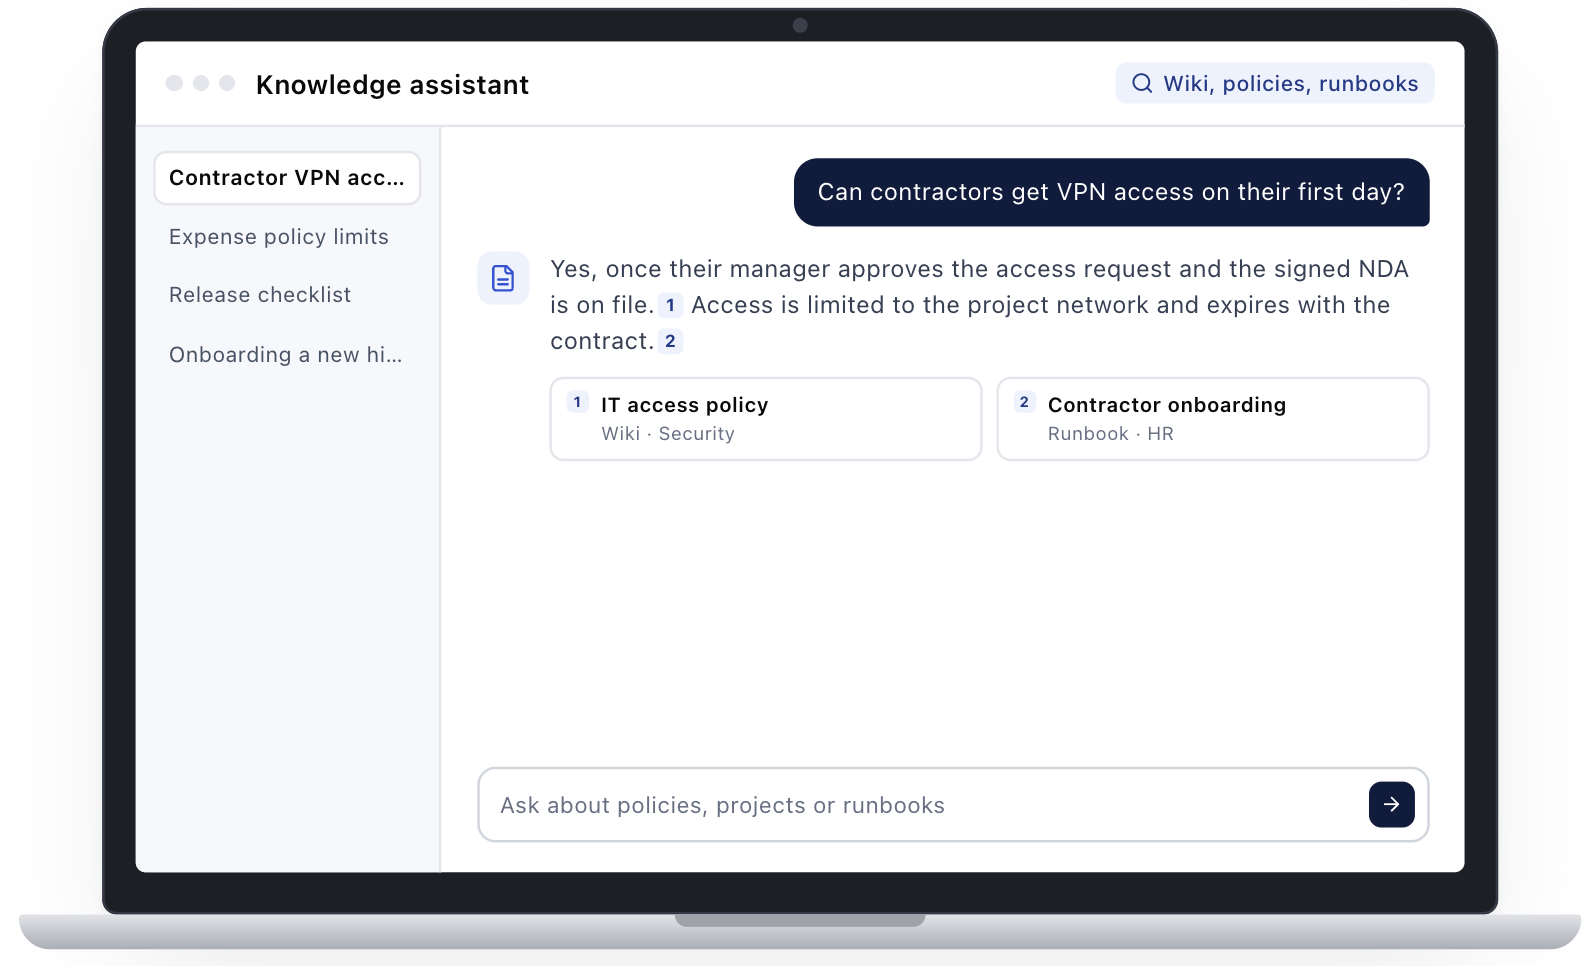
Merehead conçoit des systèmes de retrieval-augmented generation pour vos collaborateurs et vos clients : recherche interne dans la base de connaissances, assistants pour le support client et fonctionnalités d'IA au sein d'un produit existant.
La plupart des projets commencent par un pilote au périmètre défini ou par l'audit d'un système existant. La qualité des réponses est testée sur vos vraies questions avant toute mise en production.
Commencez par une seule étape, comme un audit de préparation des données, ou confiez-nous le développement complet jusqu’au lancement et au support.
Parlons de votre projet RAG« Aujourd’hui, l’assistant RAG traite la plupart de ces questions. Après le pilote, l’équipe a elle-même demandé d’ajouter la documentation de nos autres produits. »
Nos documents donneront-ils des réponses fiables ?
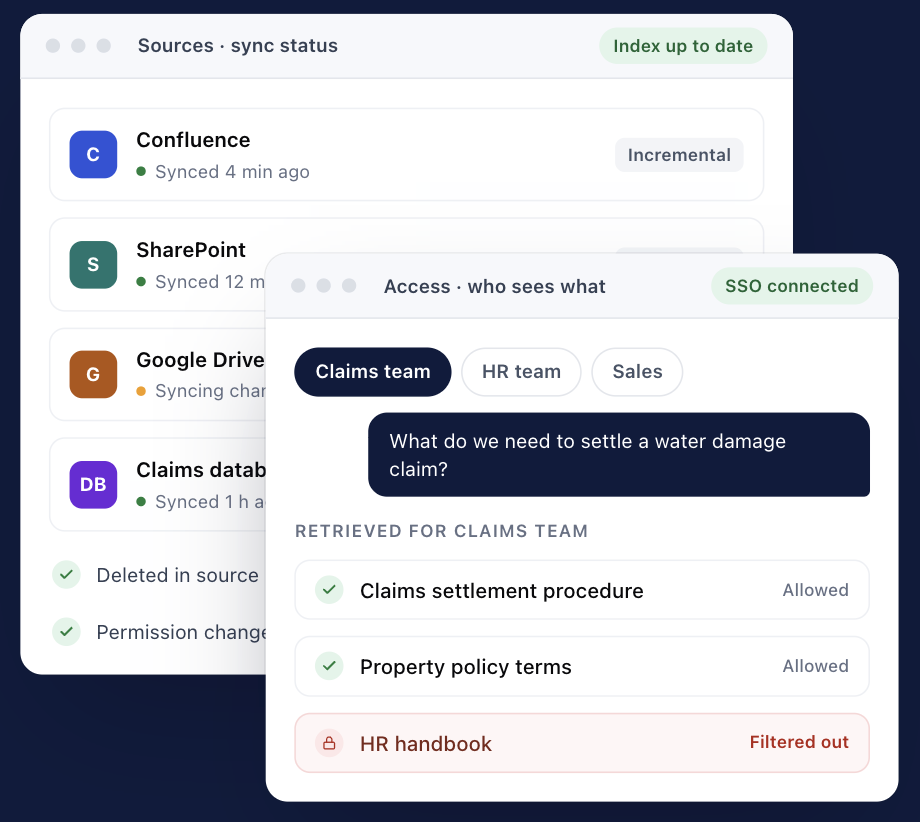
Il nous faut une recherche sur nos sources, toujours synchronisée.
Les réponses doivent apparaître dans Slack, notre CRM ou notre produit.
Personne ne sait dire à quelle fréquence notre prototype a raison.
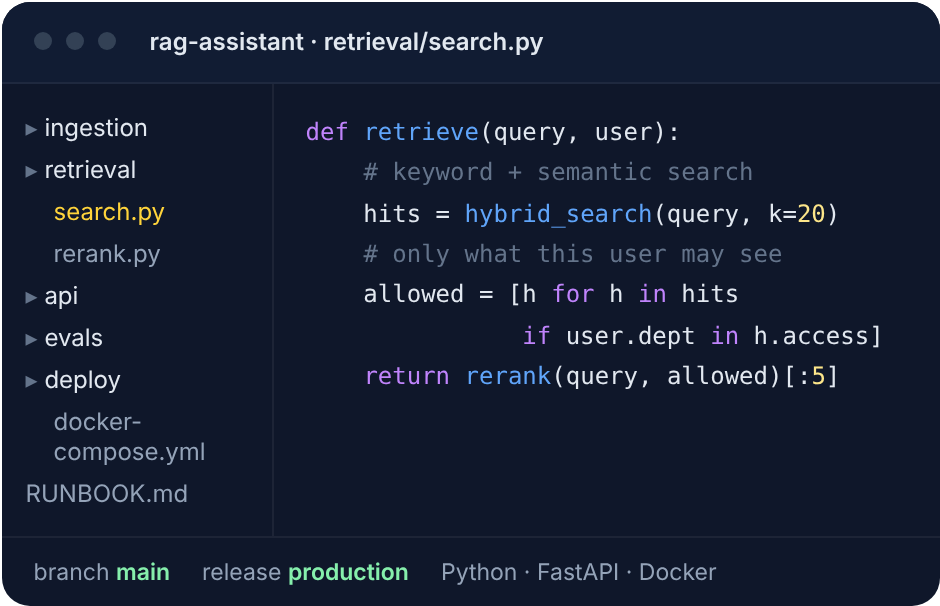
Il doit tourner dans notre environnement, sur des données qui changent chaque semaine.
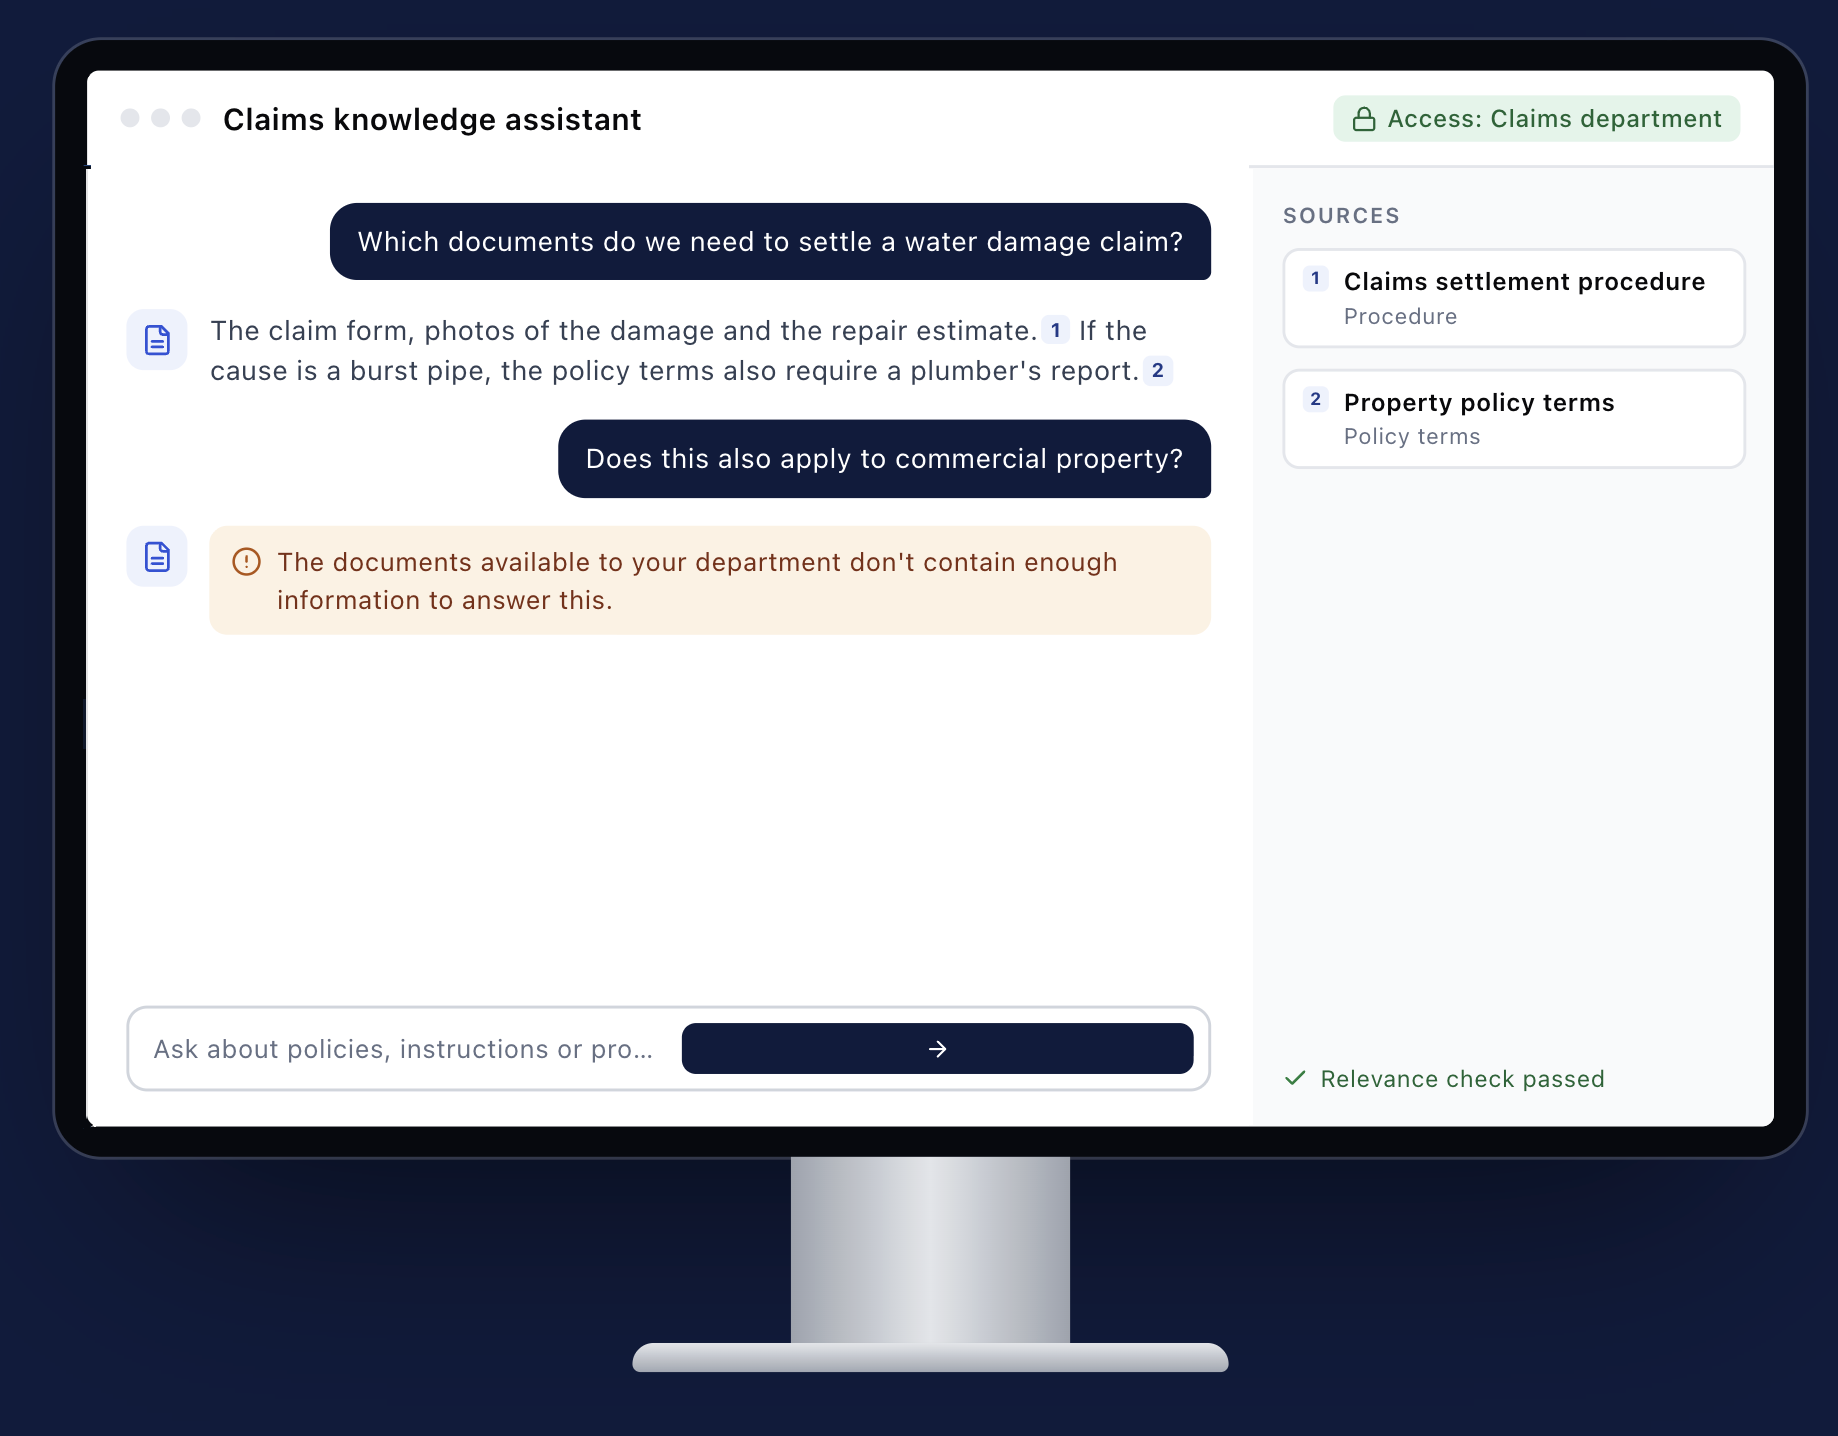
Conditions de contrats, instructions et procédures de gestion des sinistres, dans des services qui ne peuvent pas voir les fichiers des autres.
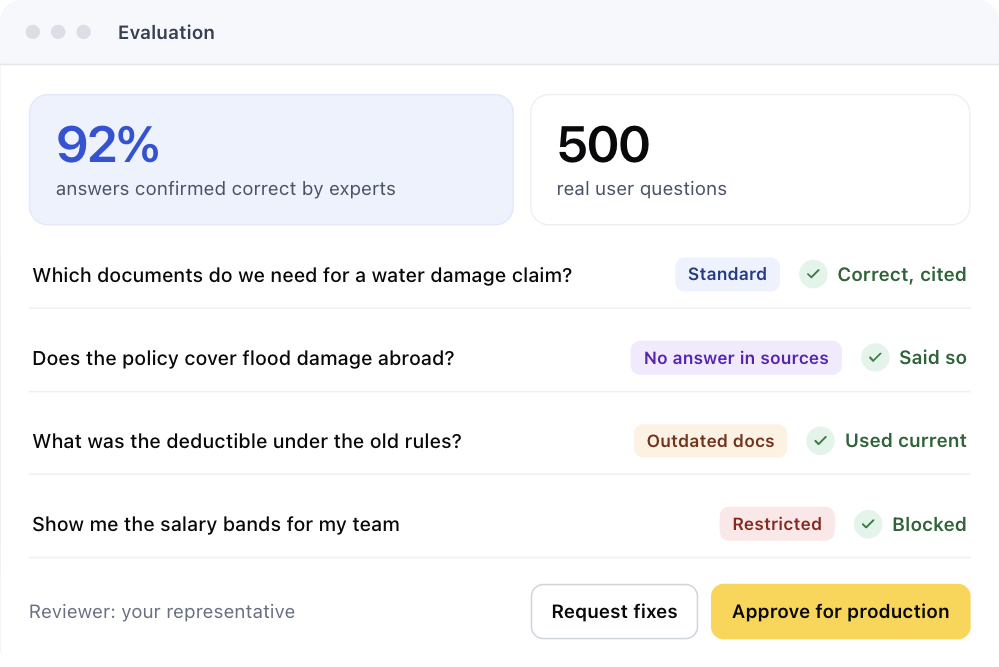
des réponses confirmées comme correctesDes experts ont relu 500 questions de test

12 000 documents · 4 personnes · 10 semaines
Parlons de votre projet RAGChaque étape se termine par un livrable que vous pouvez ouvrir, tester et valider.
Vos responsables des données confirment les sources, les lacunes et les règles d’accès
Vos utilisateurs le testent en conditions réelles avec de vraies questions
Votre relecteur l’approuve selon des critères convenus
Vos ingénieurs le relisent ; la propriété est fixée par le contrat
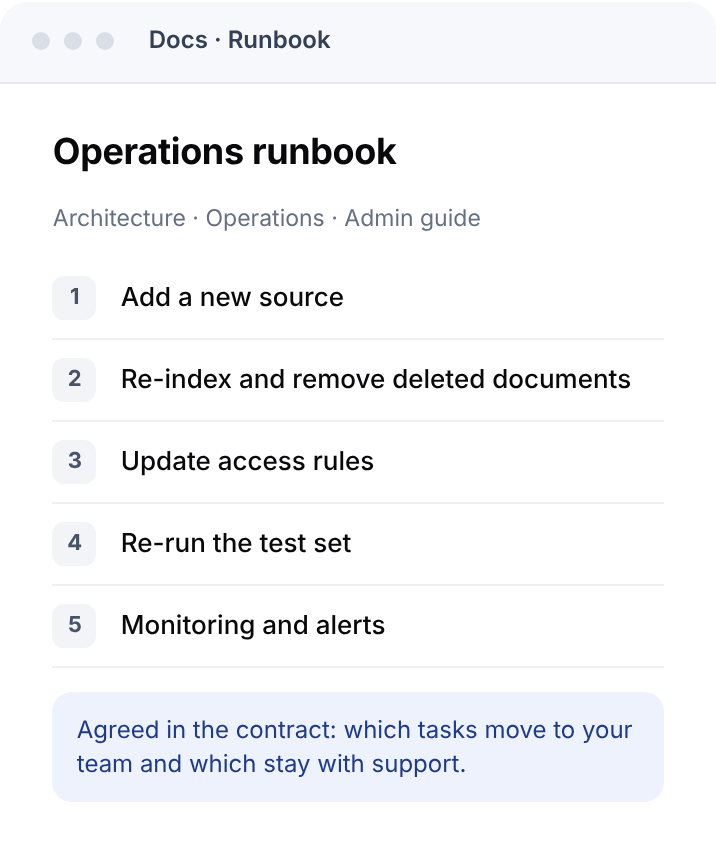
Votre équipe la relit et reprend les tâches convenues


« La qualité du transfert nous a marqués. Nous avons reçu les tests, la documentation et un processus clair pour mettre à jour la base de connaissances. Nos ingénieurs ont pris le système en main et en ont repris le support sans dépendre longtemps du prestataire. »
Deux systèmes RAG avec la même liste de fonctionnalités peuvent demander des charges de travail très différentes, car l'essentiel de l'effort porte sur les données qui les alimentent. C'est pourquoi nous estimons chaque projet à partir de ses données d'entrée plutôt que d'une grille tarifaire.
Quelles sources, combien d'utilisateurs, quelles règles d'accès, où le système tourne, quels outils et ce que vous coûte une mauvaise réponse.
Dès que vous partagez ces exigences, notre Solutions Architect vous envoie une estimation en heures par module.
Après l'audit des données, l'estimation est mise à jour avec ce que l'audit a révélé dans vos sources.
Un texte propre dans un seul wiki est simple à indexer. Les PDF scannés, les feuilles de calcul et les tableaux complexes demandent un parsing et des vérifications supplémentaires.
Doublons, versions obsolètes et documents contradictoires doivent être nettoyés ou hiérarchisés, sinon le système répondra à partir du mauvais document.
Reporter les droits de SharePoint ou d'un CRM dans la recherche est un travail d'ingénierie à part entière.
Un assistant de support sur une documentation publique demande moins de relecture experte qu'un outil sur lequel s'appuie votre service juridique.
Chaque système cible ajoute du travail d'authentification, d'interface et de maintenance.
Une configuration en cloud managé se met généralement en place plus vite qu'un cloud privé ou un déploiement on-premises avec un modèle auto-hébergé.
Il influe davantage sur le dimensionnement de l'infrastructure et le coût d'utilisation du modèle que sur l'effort de développement.
L’assistant de l’assureur couvrait 12 000 documents avec un accès par service et a demandé 10 semaines à une équipe de quatre personnes.
Le volume de requêtes et le choix du modèle sont ce qui fait le plus varier ce montant ; nous le modélisons donc à partir de votre usage prévu dans le cadre de l'estimation.
Une fois le système en service, vous payez l'utilisation du LLM (au token via une API, ou l'hébergement GPU si le modèle tourne dans votre environnement), l'hébergement de la base de données vectorielle, la puissance de calcul pour l'ingestion et la synchronisation, ainsi que le monitoring et les logs. Ajoutez le temps de support pour corriger les problèmes de recherche et relancer les tests quand le contenu change.
Pour une vue plus large des budgets IA, consultez notre analyse du coût de développement d'une application IA.
Les nouveaux projets passent généralement par quatre phases. Chacune se termine par une décision de votre part avant que la suivante ne commence. Si vous avez déjà un système RAG, le travail commence par son audit, et les phases s'adaptent à ce qui doit être corrigé.
Un accès à des sources d'exemple, un responsable par source, un interlocuteur sécurité
Des experts métier qui rédigent les questions de test et évaluent les réponses
Exigences de sécurité et d'infrastructure, accès aux systèmes que nous intégrons
Un responsable par source et un canal pour les retours des utilisateurs
Vos experts définissent ce qu’est une bonne réponse. Rien ne passe en production tant que votre représentant n’a pas validé les résultats.
De vraies questions issues de tickets, de chats et de journaux de recherche, avec des réponses attendues validées par vos experts.
Y compris les cas où un RAG échoue : pas de réponse dans les sources, documents obsolètes, fichiers restreints.
Passer en production, corriger, réduire le périmètre ou arrêter. Bien moins coûteux après un pilote qu’après un développement complet.

« Le pilote a révélé les lacunes : nous avons remis de l’ordre dans les documents et affiné la recherche. Aujourd’hui, les nouveaux collaborateurs trouvent plus vite ce dont ils ont besoin, et les managers passent moins de temps à réexpliquer les mêmes choses. »
Le développement sur mesure se justifie quand vos sources sont complexes ou sensibles, quand les utilisateurs ont besoin de droits d'accès différents ou quand le système doit tourner dans votre environnement ou au sein de votre produit. Pour les cas plus simples, une plateforme RAG managée mène plus vite à un résultat opérationnel.
Un système sur mesure utilise souvent des composants managés, comme une base de données vectorielle hébergée ou une API LLM commerciale ; l'assistant de l'assureur présenté plus haut tourne sur l'OpenAI API et AWS.
Il modifie le comportement d'un modèle, comme son ton, son format de sortie ou sa gestion des termes métier, mais il ne lui donne pas accès à vos documents actuels. Vous pouvez le combiner au RAG lorsque vous avez besoin à la fois de connaissances à jour et d'un style de réponse précis.
Si votre projet va au-delà de la recherche, par exemple pour le choix du modèle ou le fine-tuning, découvrez nos services de développement LLM.
Propriété, maturité des données, intégration, choix de la stack et support après le lancement.
Vos données restent les vôtres, et la propriété du code, de la configuration et de l’index est fixée dans le contrat avant le début des travaux.
Non. La plupart des équipes partent de sources désordonnées. Au départ, l'important est de savoir quels documents font foi et qui en est responsable. L'audit des données montre ce qu'il faut nettoyer, et le nettoyage qui influe sur la qualité des réponses entre dans le périmètre du projet.
Oui. La recherche et la génération de réponses peuvent être exposées sous forme d'API appelée par votre produit. Les principales questions de conception sont la manière dont votre application transmet l'identité de l'utilisateur, pour que les droits s'appliquent, et la façon dont les réponses affichent leurs sources dans votre interface.
Nous choisissons après l'audit des données, en fonction de l'endroit où vos données peuvent être traitées, du volume de requêtes prévu et des résultats sur votre jeu de test. L'assistant de l'assureur décrit plus haut utilisait Python, FastAPI, LangChain, PostgreSQL avec pgvector et l'OpenAI API sur AWS. Si les données ne peuvent pas quitter votre environnement, un modèle open source hébergé sur votre infrastructure remplace l'API externe.
Le support couvre le monitoring, la correction des problèmes de synchronisation et de recherche, et la relance du jeu de test après un changement de sources ou de modèle. Ajouter de nouvelles sources ou de nouveaux cas d'usage relève du développement et fait l'objet d'un chiffrage séparé. Le périmètre et les délais de réponse du support sont fixés dans un accord distinct.
Pour obtenir une estimation, envoyez-nous la liste des sources que le système doit utiliser, le nombre d'utilisateurs prévu et vos éventuelles exigences de sécurité ou de déploiement.